前几天我想搞清楚一件事:百度到底喜不喜欢我的博客。
翻服务器日志最直接 —— 蜘蛛什么时候来、抓了什么、返回什么状态码,那儿写得清清楚楚。但日志有好几万行,我不想手翻,就让 WorkBuddy 写了个脚本去统计。
翻到一条结果的时候我停住了:
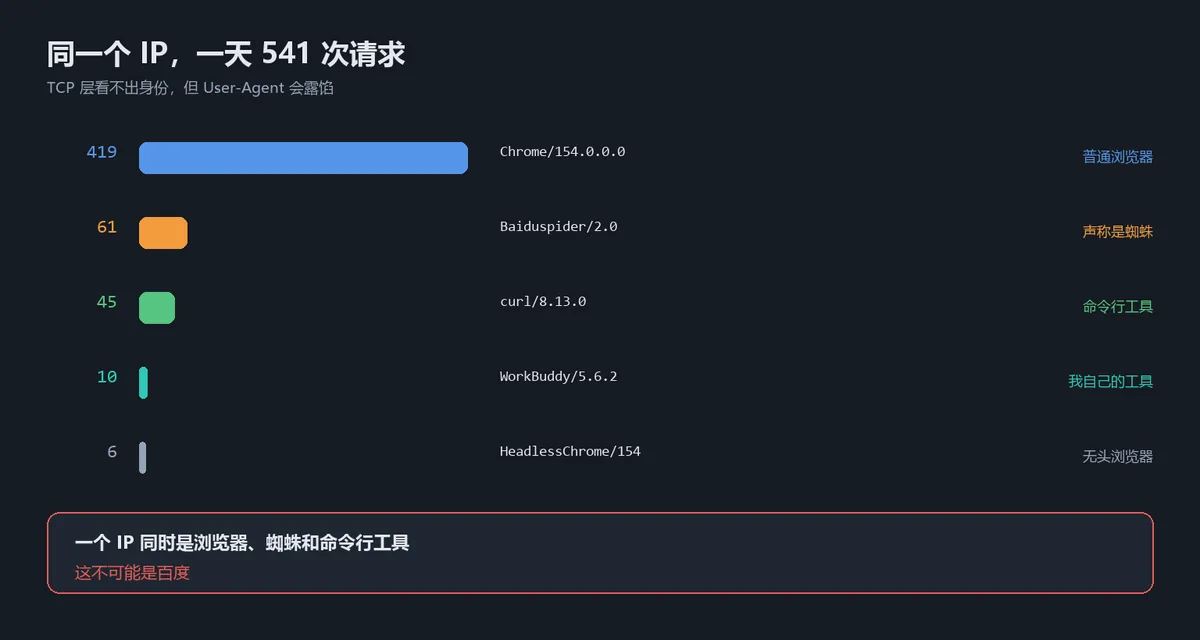
Baiduspider 抓取:61 次61 次。而且时间点跟我前一天在百度站长平台提交收录的时间高度吻合。
当时挺高兴的。
那 61 次「百度蜘蛛」是我自己
高兴了大概五分钟。
然后我注意到一件事:这 61 次请求全都来自同一个 IP。
一个 IP 抓 61 次不奇怪。奇怪的是这个 IP 还在干别的事。我拉出它当天的完整记录:
419 次  Chrome/154              ← 有人在用浏览器
 61 次  Baiduspider/2.0         ← 蜘蛛
 45 次  curl/8.13.0             ← 有人在敲命令
 10 次  WorkBuddy/5.6.2         ← 我自己在用的工具
  6 次  HeadlessChrome/154
一个 IP,同时是浏览器、蜘蛛和命令行工具 —— 还带着我自己的工具标识。
这不可能是百度。
往下看还有更直接的:这个 IP 有一批请求的 referer 是 https://www.baidu.com/link?url=... —— 那是百度搜索结果的跳转链接,只有真人点击才会产生。真蜘蛛不会带这个。
那是我的出口 IP。我在百度上搜自己的站、点进去看、又用命令行验证 robots.txt —— 这些动作全被日志如实记下来了,然后被我一厢情愿地读成了「百度来抓我了」。
那真正的百度来过吗?来过。全日志里只有 1 次:
220.181.108.175 - - [28/Sep/2026:20:30:32 +0800]
"GET / HTTP/2.0" 200 10803
"Mozilla/5.0 (compatible; Baiduspider/2.0; ...)"
IP 落在 220.181.0.0/16 段里,是百度官方地址。抓的是首页,返回 200。就这一次。
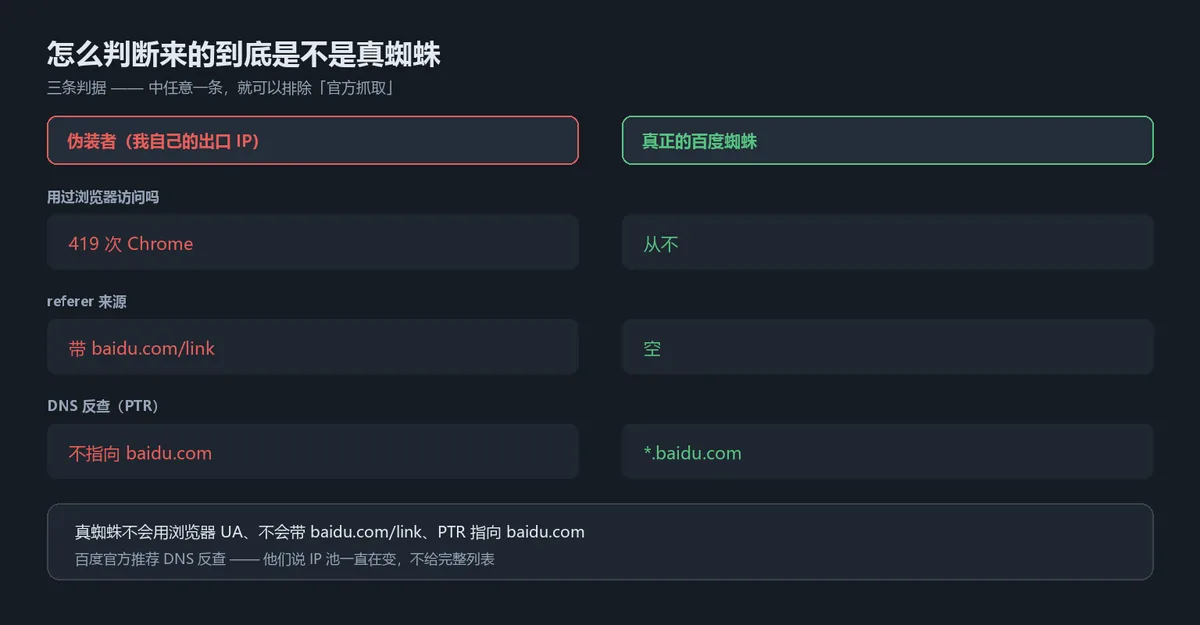
百度官方给的验证方法其实只有一条:DNS 反查。
$ host 220.181.108.175
175.108.181.220.in-addr.arpa domain name pointer baiduspider-220-181-108-175.crawl.baidu.com.
PTR 记录是 .baidu.com 或 .baidu.jp 才算真,其他一律按冒充处理。他们说得很直白:IP 池一直在变,不给完整列表 —— 所以别靠 IP 段硬判,靠反查。
(顺便澄清一个我自己也搞错过的点:协议版本不能拿来判真伪。真百度蜘蛛 HTTP/1.1 和 2.0 都在用,我一开始看到「全是 1.1」还以为抓到证据了,其实不是。)
但日志没白翻:两个问题藏了两年
自嘲完了说正事。翻日志真正有价值的地方是 —— 能看到哪些请求一直在失败。
我按失败次数排了个序,第一名让我愣了一下:
/favicon.ico 被请求 250+ 次,全部失败favicon 就是浏览器标签页上那个小图标。我从来没配过它。
具体怎么失败的:
$ curl -sI https://我的站/favicon.ico | head -1
HTTP/1.1 302
302,重定向到首页。
这比 404 更糟。搜索引擎来要一张图,服务器说「你去首页拿」—— 首页是 HTML,不是图片。这种错有个名字叫软 404:不报错,但等于没有,而且每次抓取都白吃一个来回。
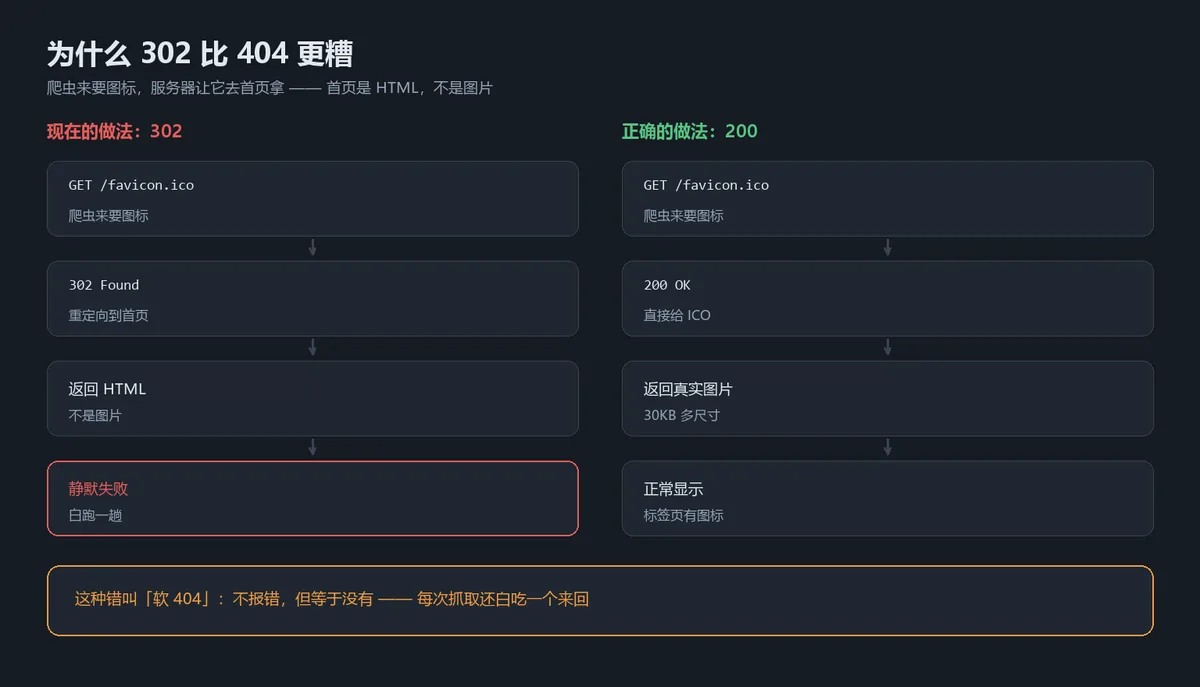
翻了下服务器根目录,确实没这个文件;页面里也没有任何图标声明;WordPress 后台的 site_icon 是 0。三个地方全是空的 —— 这站跑了两年,一直没图标。
顺着往下还有第二个:两个老 URL 被反复请求,全 404。一个是老式的 /sitemap.html 入口,一个是我改过 slug 的旧标签地址。都做了 301 跳到新地址 —— 301 能把已有的权重传过去,比放着 404 强。
(顺带提一句:改 URL 之前得先查清那个地址到底谁在管,不然容易白改。我在这篇里踩过。)
如果你也想自查,三条命令就够:
# 1. 图标是否正常(要 200;302 和 404 都不行)
curl -sI https://你的站/favicon.ico | head -1

# 2. 哪些路径在反复失败(按次数倒序)
grep -E '" (404|302) ' /path/to/access.log \
  | awk '{print $7}' | sort | uniq -c | sort -rn | head

# 3. 哪些老链接还在吃 404(挑出高频的做 301)
grep ' 404 ' /path/to/access.log | awk '{print $7}' | sort -u | head -20
第二条最有用 —— 我那两个藏了两年的问题,就是这么揪出来的。
修完之后,我用脚本做了一遍全量复验
favicon 的修法本身没难度:生成图标文件、页面里加声明、nginx 加一条精确规则让它吃静态文件、不再落到 WordPress。
location = /favicon.ico {
    try_files $uri =404;
    access_log off;
    expires 30d;
}
(改 nginx 有个老规矩:写完先 nginx -t 校验,不过就回滚,别带病重载。这个流程我之前在改 nginx 的正确姿势里写过。)
改完实测:
$ curl -sI https://我的站/favicon.ico | head -1
HTTP/1.1 200 OK                    # 原来是 302

$ curl -sI https://我的站/sitemap.html | head -1
HTTP/1.1 301 Moved Permanently     # 老入口已跳转
真正让我安心的是复验。这站的日常运维我全交给脚本了 —— 都是让 WorkBuddy 写的,每个改动都配一条校验命令。改完跑一遍全套:
| 校验项 | 结果 |
|---|---|
| meta 标签 | 68/68 |
| SEO 结构 | 21/21 |
| 子站屏蔽 | 25/25 |
| 死链 | 13/13 |
| 链接结构 | 19/19 |
| 图标(本次新增) | 12/12 |
| 合计 | 211/211 |
211 项,全绿。
这一步不能省。手动改网站最怕的就是「改好了 A、弄坏了 B」—— 尤其 SEO 这类改动,页面看上去一模一样,问题全藏在 HTML 里。有校验脚本兜着,才敢说一句「改完了」。
最后
有件事得说清楚:百度对新站有观察期。
我现在 3 篇文章,百度只来过 1 次 —— 这不是病,是正常状态。新域名的首次抓取通常要等 1 到 4 周,提交收录不会让它提前。急也没用,能做的只有把站本身弄干净 —— 上线该检查的项目我列过一份清单。
真正的信号只有三条:内容是不是原创、有没有别的站给自然外链、是不是持续在更新。
至于那 61 次「蜘蛛」到底从哪来,我还没查到确切答案 —— 大概率是我自己某个工具在模拟蜘蛛 UA 做自检。所以现在多了个习惯:翻日志时,先确认那个爬虫是不是我自己。