10 个词,首页大站数全是 0。
我看着这列 0 挺高兴。在我的判据里,大站数 0 等于「这个词没人抢」,等于可以做了。
我那个脚本在干什么
筛虚拟资料品类的时候,我要判断一个词竞争大不大。想法很朴素:把百度首页前 20 条结果的域名扒下来,数一数里面有几个是文库、素材站这种大站。大站多,说明抢不过;首页里贴吧和小站多,说明有机会。
脚本的核心就一个函数:
def serp_domains(w):
    url = "https://www.baidu.com/s?wd=" + urllib.parse.quote(w) + "&rn=20"
    html = urllib.request.urlopen(
        urllib.request.Request(url, headers=UA), timeout=15
    ).read().decode("utf-8", "ignore")
    doms = re.findall(r'mu="(https?://[^"]+)"', html)
    return doms[:10]

def classify(doms):
    big = sum(1 for d in doms if any(b in d for b in BIG))
    opp = sum(1 for d in doms if "tieba.baidu.com" in d)
    return big, opp
BIG 是一张大站关键词表,里面有 wenku、zhidao、baidu.com、docin、51miz。首页命中的大站越多,越难做。
第一批 10 个种子词跑出来很正常。ppt模板下载 大站 3 个,简历模板下载 6 个,私域运营sop 7 个 —— 都有数。
第二批话术类的 10 个词,全是 0。大站 0,贴吧 0,知道 0。
第二个 0 让我停住了
那 10 行在 CSV 里我标的是「限流无数据」。当时我觉得这个标注挺谨慎的 —— 知道是抓取有问题,才标成无数据,而不是当成真的没竞争。
转折是在另一批词上。选品验证_长尾细分.csv 的最后四行,二手房买卖合同模板下载、劳务合同模板下载、婚礼主持词完整版、幼儿园家长会发言稿模板,大站 0、贴吧 0、小站 0,域名样本列整列是空的。
域名样本都空,那一行显然一个域名都没抓到。可判定列写的是「边缘」,不是「无数据」。同一个脚本,同一种失败,两种记法。我当时没管它。
我以为 0 是竞争小。
再跑一遍,两个 0 根本不是一回事
昨天我把这事重新试了一次。同一个 IP,同一个 UA,同一批词。
PC 端 www.baidu.com 返回的东西,长这样:
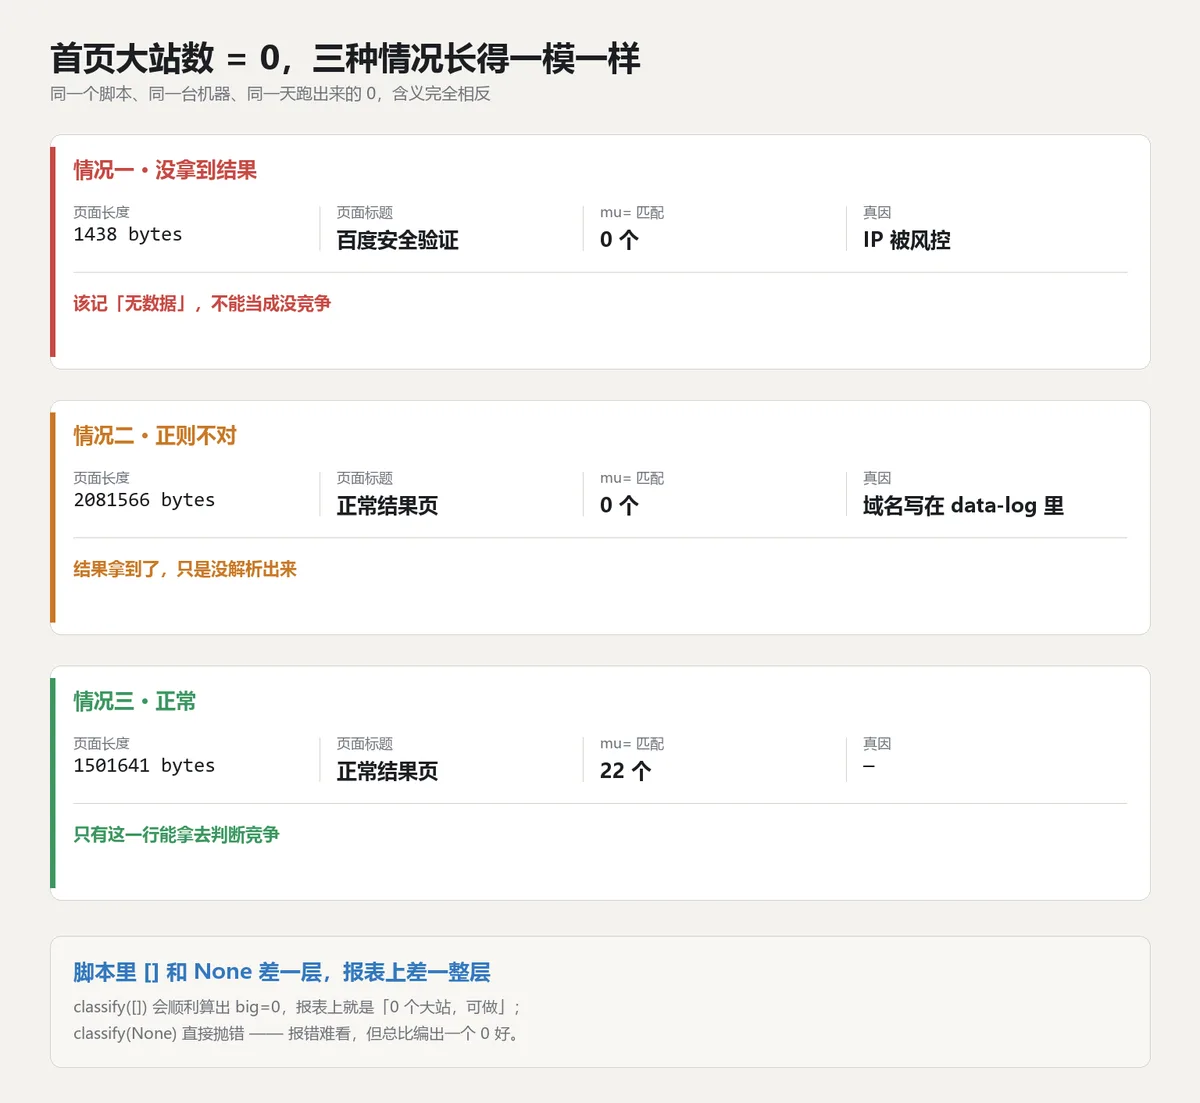
1438 bytes
<title>百度安全验证</title>
一个域名都匹配不到,因为页面里压根没有结果。安全验证页不是 403,不是报错,状态码正常,页面也能打开 —— 你不检查长度,会以为这就是一次成功的查询。
移动端是另一种情况。m.baidu.com 返回 2 MB 正常页面,但我脚本里那个 mu="..." 正则匹配出来 0 个。移动端的域名写在 data-log 属性里,我数了一下,43 处。
所以「首页大站数 0」这个数,有两个完全不同的来源:
| 现象 | 真实原因 | 正确记法 |
|---|---|---|
| 页面 1.4 KB,标题写「百度安全验证」 | IP 被风控,没拿到结果 | 无数据 |
页面 2 MB,mu= 匹配 0 个 |
页面拿到了,正则不对 | 无数据 |
页面 2 MB,mu= 匹配 10 个 |
正常 | 按数据算 |
三行在 CSV 里长得一模一样。前两行都不该进「能不能做」的判断。
我现在怎么拦它
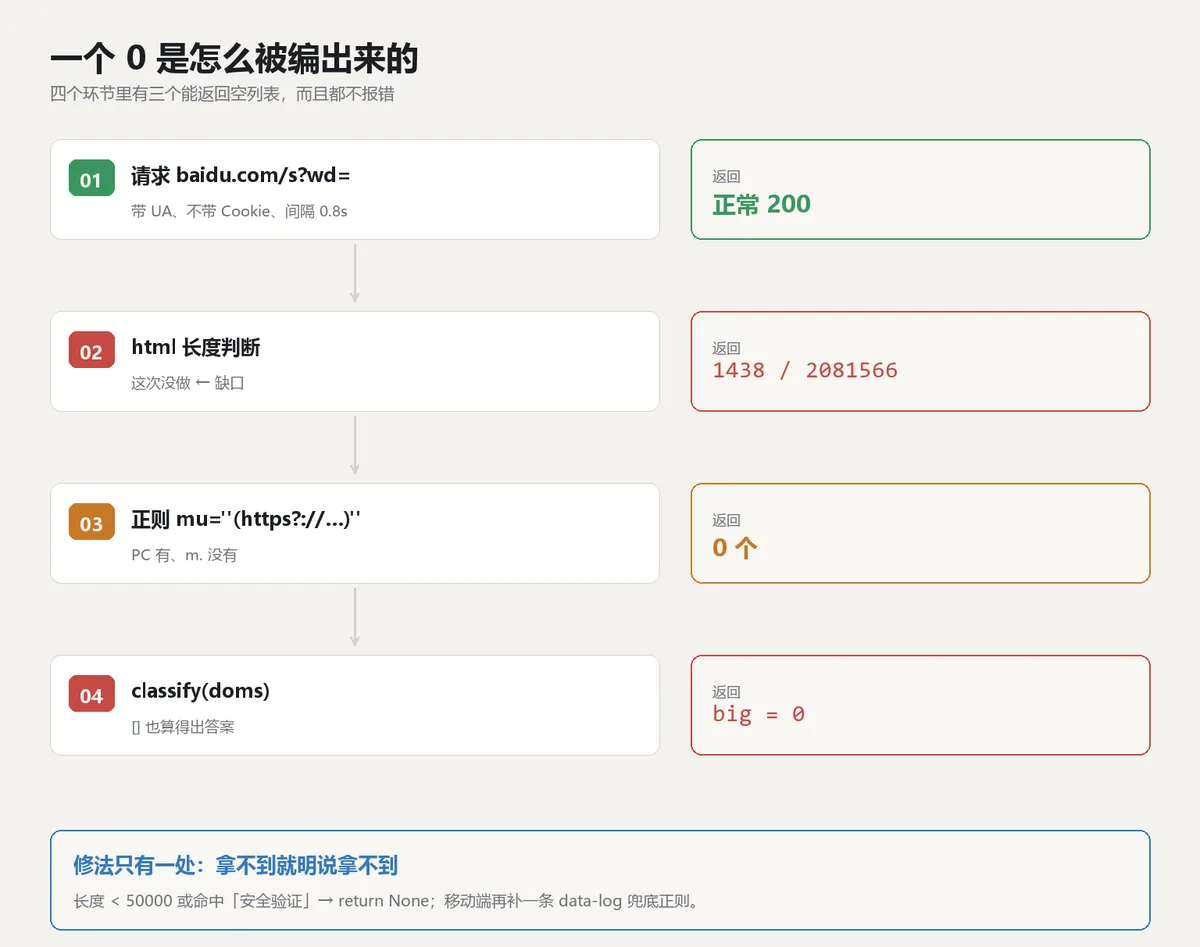
先看长度,再看标题。1438 字节和 2 MB 差三个数量级,一个阈值就够:
def serp_domains(w):
    html = fetch(url)
    if len(html) < 50000 or "安全验证" in html:
        return None          # 拿不到就明说拿不到
    doms = re.findall(r'mu="(https?://[^"]+)"', html)
    if not doms:
        doms = re.findall(r'data-log="[^"]*url=([^&"]+)"', html)  # 移动端兜底
    return doms[:10]
返回 None 而不是空列表。这两个值在下游完全不同:[] 会顺利穿过 classify() 变成 0,None 会直接报错。报错难看,但我宁愿它报错。
跑完看一眼 CSV 就能确认:
grep -c "安全验证" serp.log
awk -F, 'NR>1 && $4==0 {print $1}' 选品验证.csv
第二条列出来的每个词,我都要重新手查一遍首页。人工查也不复杂,打开首页看帖子的发帖时间 —— 近一年的说明位置还轮得到你,全是三四年前老帖的就别碰。这个判据我之前写过一篇专讲:挖到的词全是 -1,怎么判断有没有搜索量。
顺带说一句,我这类判断错得最勤的时候,都是在拿一个「看起来像数据的 0」当结论。同一个坑我还在别处犯过 —— 日志里 61 次百度蜘蛛其实是我自己,UA 写着 Baiduspider,一过滤 IP 段全露馅了。0 和假蜘蛛是同一类东西:数字摆在那儿,含义得自己核。
现在我把首页抓取这一步的每个词都手动核了一遍。那批话术词到底有几个能做,我得等 IP 冷静下来重跑一次才知道 —— 那天它们全在「无数据」里,没一个能当结论用。这套判定在冷 IP 上稳不稳,我还没测够,不确定能撑多久。