先说结论:我不知道百度听谁的,这才是问题所在。
多个 robots 标签并存时到底怎么合并,百度没给过明确说法。Google 的文档写明冲突时取最严格的那条,但我不想拿收录去赌这个默认值。真正麻烦的是另一件事——这种矛盾不报错,页面照常 200,HTML 照样合法。
9 月 28 号晚上做全站体检,我在自己的标签页 head 里翻出这么两行:
<meta name='robots' content='max-image-preview:large, index, follow, ...' />   ← 我的新插件
<meta name="robots" content="noindex,follow" />                              ← 老插件
一个让收,一个不让收。
矛盾是怎么凑到一起的
两个插件各自看都对。
老插件把标签页设成 noindex,follow 是有意的:标签页、空分类页、作者页属于低质聚合页,是批量建站被判垃圾站的重灾区,我不想它们进索引。follow 也是故意留的,蜘蛛顺着链接还能抓到正文——那 61 次「百度蜘蛛」,其实是我自己那篇里抓的就是这类页面。
新插件是当天刚写的,任务是补 description / OG / canonical,顺手也输出了 robots。它不知道前面那个决策,就按「默认可索引」给了 index,follow。
两边单独看都没错,合起来打架。
第一个弯路:我以为是主题输出的
第一反应是「把主题那行关掉」。查到的写法是这样:
add_filter( 'generate_show_robots_meta', '__return_false' );我用的是 GeneratePress,看着挺对。部署前 grep 了一把主题源码:
grep -r "max-image-preview" wp-content/themes/零结果。那行根本不是主题输出的,是 WordPress 5.7+ 核心的 wp_robots() 自己打的。generate_show_robots_meta 这个过滤器压根不存在,写上也不会有任何效果——不报错,就是没反应。
正确入口是官方的 wp_robots 过滤器。写 filter 名字之前先 grep 源码,别凭印象。
第二个坑:index 又回来了,而校验说没问题
改用 wp_robots 重新部署,我以为完事了。抓下来的标签还是不对:
noindex, follow, max-image-preview:large, index, max-snippet, max-video-previewindex 还在里面。我只做了 unset($robots['index']),管不着后面还有别的过滤器在更晚的优先级把它加回去。
更难受的是校验脚本当时报「通过」。它是这么判的:
chk("index" in robots, "robots 输出正常")问题在于 index 是 noindex 的子串。"index" in "noindex" 返回 True,所以不管这一页声明的是收录还是不收录,这行永远过——检查形同虚设,矛盾值照样绿灯。
一个用来查矛盾的检查,自己先瞎了。
改成按逗号拆分、逐项精确比对:
toks = [x.strip() for x in d["robots"].split(",")]
chk("noindex" in toks, "含 noindex")
chk("index" not in toks, "不含矛盾的 index")
三层修法
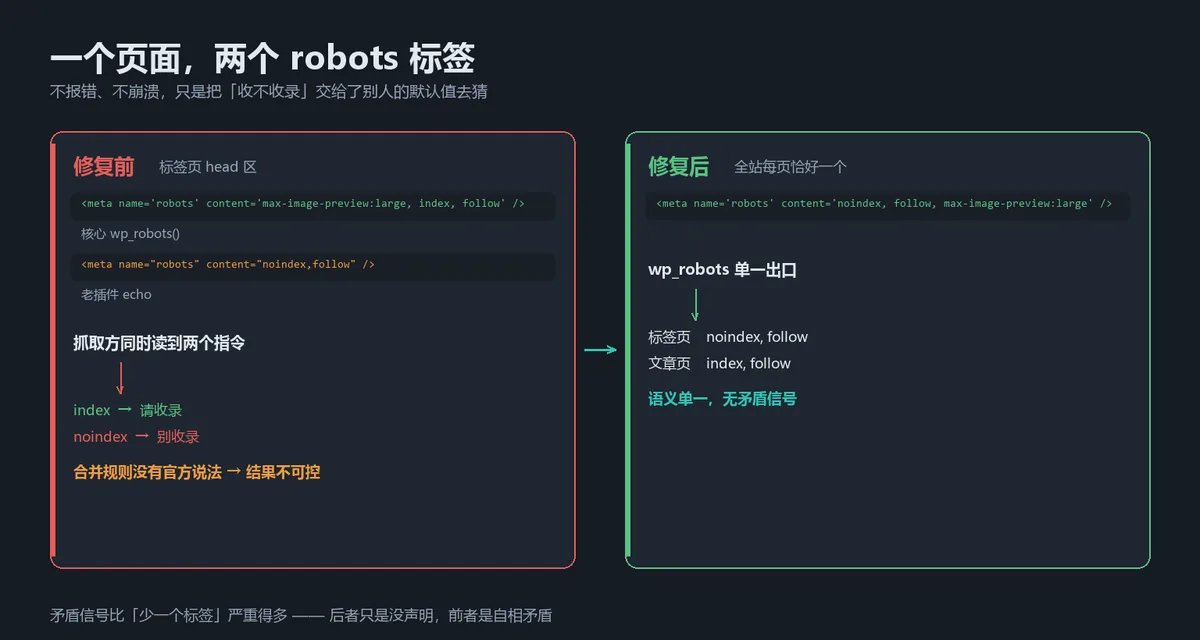
一是老插件不再 echo 自己的 <meta>,改走 wp_robots 过滤器,全站只保留核心输出的那一个标签;二是判定函数抽成 zz_seo_is_noindex(),两个插件都调它,从根上断掉规则分叉;三是 noindex 时直接重建整个数组,不给后来的过滤器留插空子的机会:
add_filter( 'wp_robots', function ( $robots ) {
    if ( zz_seo_is_noindex() ) {
        $robots = array(
            'noindex'           => true,
            'follow'            => true,
            'max-image-preview' => 'large',
        );
    }
    return $robots;
}, 9999 );
优先级给到 9999,收尾执行。自己写 mu-plugin 接管这类输出,好处就在这——自己写个 WordPress 插件,让发文自动推送百度收录那篇也是同一个思路。
顺带还有个坑:grep '<meta name="robots"' 会漏判,因为 WordPress 核心输出用的是单引号。得这么写:
curl -s https://你的域名/tag/xxx | grep -oiE "<meta name=['\"]robots['\"][^>]*>"改完之后每页恰好一个 robots 标签:标签页 noindex, follow, ...,文章页 ..., index, follow, ...。68 项校验全过,连同其它脚本一共 199 项复验也是全绿。
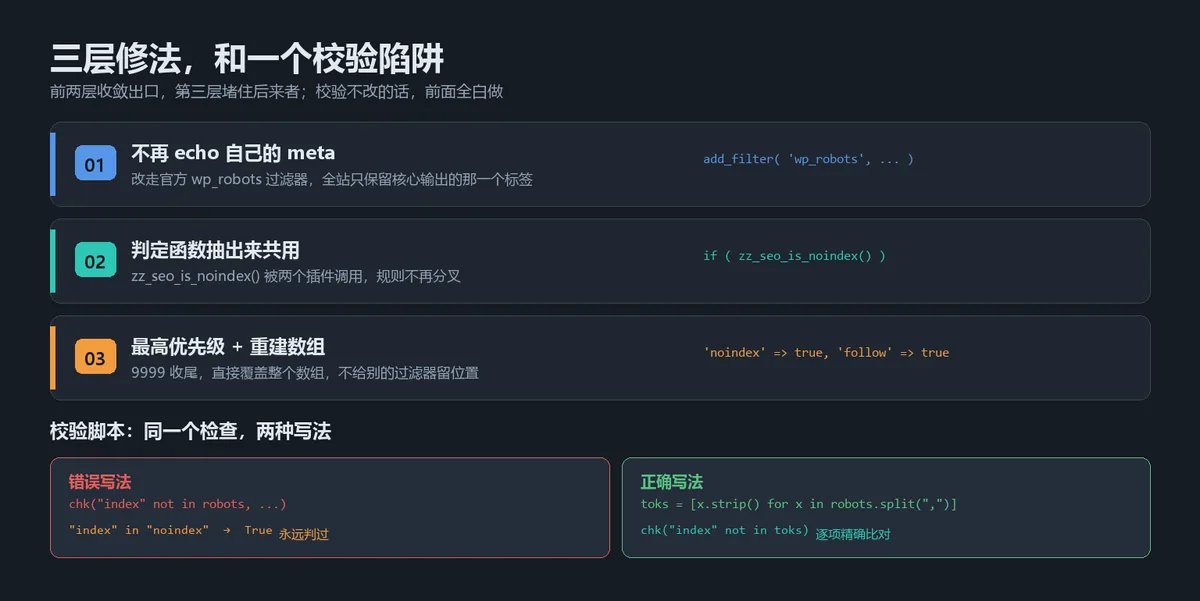
凡是「一个页面只能有一个」的标签——canonical、description、robots——都应该收敛到单一出口,并且校验脚本要强制检查数量等于 1,而不只是检查内容对不对。数量错了,内容检查得再细也是白搭。