先说结论。字幕翻译跑出别的语种,多半不是模型坏了,是调用格式不对。
我是在数标签的时候才反应过来的。
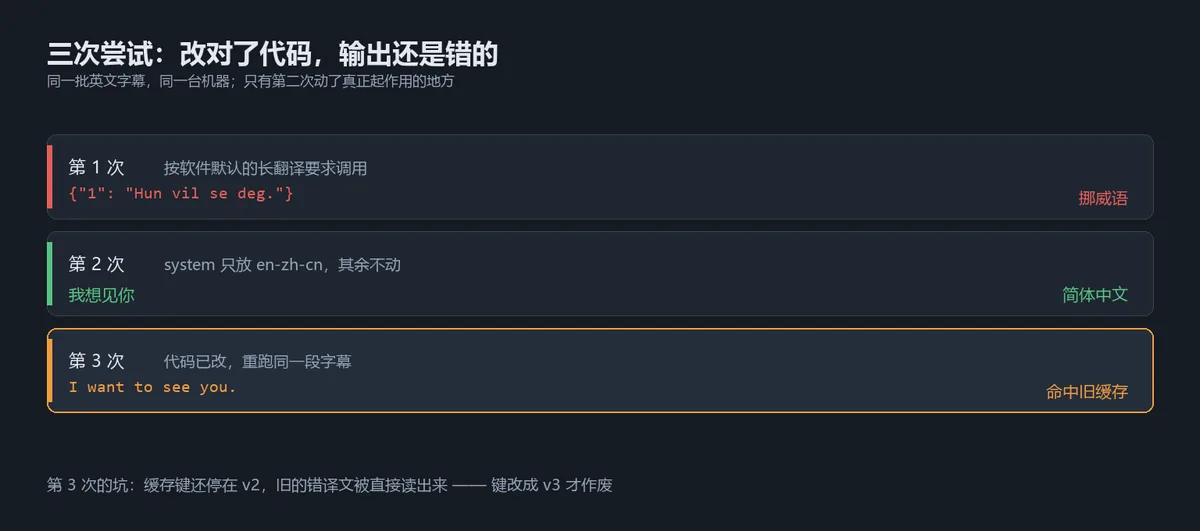
那一批英文字幕跑出来是挪威语:
{"1": "Hun vil se deg."}Hun vil se deg. 是挪威语。意思是"我想见你",原文是 I want to see you.
日志里没有报错。界面显示翻译完成。缓存目录里 10:19 那一批"译文",全是英文原句。
我以为是翻译要求写得不对
那个软件翻译走的是一长串英文要求。你是专业字幕翻译,把下面每句译成目标语言,只输出 JSON。后面还能再挂一句我自己写的补充要求。
这套对通用对话模型是管用的。我也就顺着这个方向想了想——是不是漏了句"必须输出中文"。
真正让我停下来的是翻模型说明。
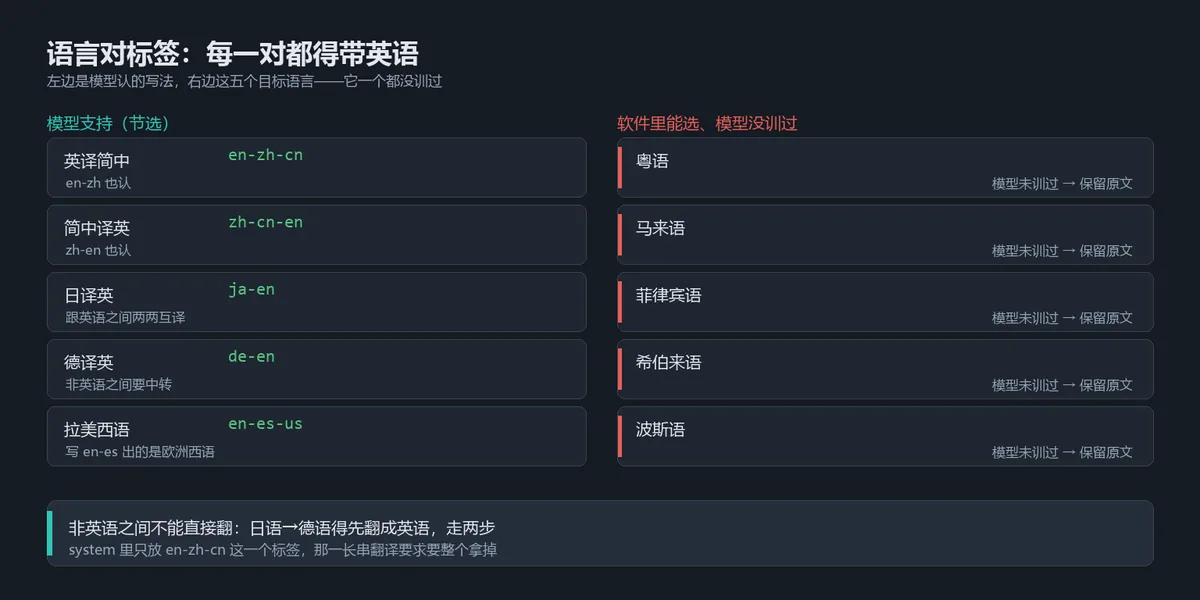
这个模型(英伟 Riva-Translate-4B-Instruct-v2)不是聊天模型。它是翻译专用模型。说明里写得很清楚:调用时在 system 位置放语言对标签,en-zh-cn 是英译简中,en-de 是英译德。
原话是 the model may not perform optimally without it。
给一个不认识指令的模型写指令。写多少遍都没用。
修法也简单。system 里只放标签,用户那边放纯文本,那一长串翻译要求整个不挂。
# 旧:system 里塞一长段翻译要求 + JSON 输出约定
system = "你是专业字幕翻译,请把下面每句译成目标语言,只输出 JSON"
user   = '{"1": "I want to see you."}'

# 新:system 只放语言对标签,user 放纯文本
system = "en-zh-cn"
user   = "I want to see you."
36 个标签里,没有我那五种语言
把支持的语言对抄下来数了一遍。规律挺清楚:每一对里都得有英语。
英译简中   en-zh-cn        简中译英   zh-cn-en
英译德     en-de           德译英     de-en
英译日     en-ja           日译英     ja-en
英译法     en-fr           法译英     fr-en
日语翻德语这种非英语之间的组合,得先翻成英语再翻过去。走两步。
麻烦的是软件里能选的目标语言,有五种不在这个名单里:粤语、马来语、菲律宾语、希伯来语、波斯语。
不是映射写错了。是模型没训过。
这五种我让软件直接跳过、保留原文,界面上给个提示。别让它默默翻成英语。
改对了,输出的还是错的
代码改完,重跑同一段字幕。出来的还是英文。
这个比第一次更让人火大。标签明明换对了。原因在缓存。
那个软件把翻译结果按"字幕内容 + 语言 + 模型名"存成一份文件。我第一次跑错的时候,错的译文已经写进去了。改完代码再跑,命中旧缓存,直接把错误结果读出来给你看。
所以修复里必须加一条。缓存键从 v2 改成 v3。键一变,v2 那批错的缓存全部作废。
查找和作废的动作是这样:
find ~/AppData -type d -name translate_results
grep -rl "Hun vil" ~/AppData/*/cache/translate_results/
grep -rn "v2\|v3" src/translate/cache.py顺带一个教训。我在这上面浪费了一个多小时:改完代码行为没变,先去翻缓存,别急着怀疑代码。
我以为修复没生效,把调用格式又检查了一遍。浪费的全是这种重复劳动。参数写对了但结果还是老样子,根子都在旧文件上留着。我写别的工具时也踩过同类的坑,WebP 压缩参数实测表那篇记的就是这个。
验证
按官方格式连测三次。temperature 0.2 和 1.0 都试了,全部输出简体中文。
再拿四句没跑过的新字幕走完整流程。四句都是中文。
粤语那批还没解决。这种模型只认英语做中转,名单里没有粤语的标签。打算换一个通用翻译模型重跑。换哪个我还没定,得看它对粤语口语的容忍度。另外本地字体那些坑又是另一码事,中文字体加载不了会静默变成方块,我在中文字体那些坑那篇里记过一遍,这里不重复。