用 Python 给文章配图,绕不开字体。我在十几张图里撞了三个坑, 三次都是同一个表现:不报错、不崩溃,只是画出来变成方块。
顺序是:中文 → 特殊符号 → 中英混排。前两个给你看方块, 第三个更阴 —— 它连方块都不给,只是让你辛苦排的表格整体歪掉。
坑一:中文扔进了等宽字体
第一次撞上是在画 favicon 对比图 —— 那是我写百度抓取排查那篇时配的, 要并排画「302 把请求送到首页」和「200 直出图片」,图上得写「返回 HTML」「静默失败」两句话。 我用的是混排函数, 签名是 (代码, 中文说明) 两个位置 —— 我图省事,把整句塞进了第一个位置, 而那个位置走的是 Consolas。
画出来是:
▯▯ HTML
▯▯▯▯
Consolas 没有中文字形。它不报错,只是给你一个空心方块。
解法是别猜,按内容选字体:
import re
_CN = re.compile(r"[\u4e00-\u9fff]")

def code_line(d, xy, text, color, size=19):
    """含中文走黑体,纯 ASCII 才走等宽"""
    if _CN.search(text):
        d.text(xy, text, font=F(size), fill=color)
    else:
        d.text(xy, text, font=FM(size), fill=color)
这里还有个盲区:正则只覆盖基本汉字区。字符串「(2)」里没有汉字, 会被判成纯 ASCII 走等宽 —— 而全角括号在 Consolas 里同样没有字形。 要连全角标点一起覆盖,范围得加上 U+FF00-U+FFEF。
坑二:修好了中文,换个符号又中招
我以为字体问题就此解决了。然后画 A/B 对照图,标对错时顺手用了 ✓ 和 ✗。
两个方块。
这两个是 U+2713 和 U+2717,属于 Dingbats 区。微软雅黑不缺中文, 缺的是这些符号 —— 它压根没收录。
我把常用符号挨个渲染出来验了一遍:
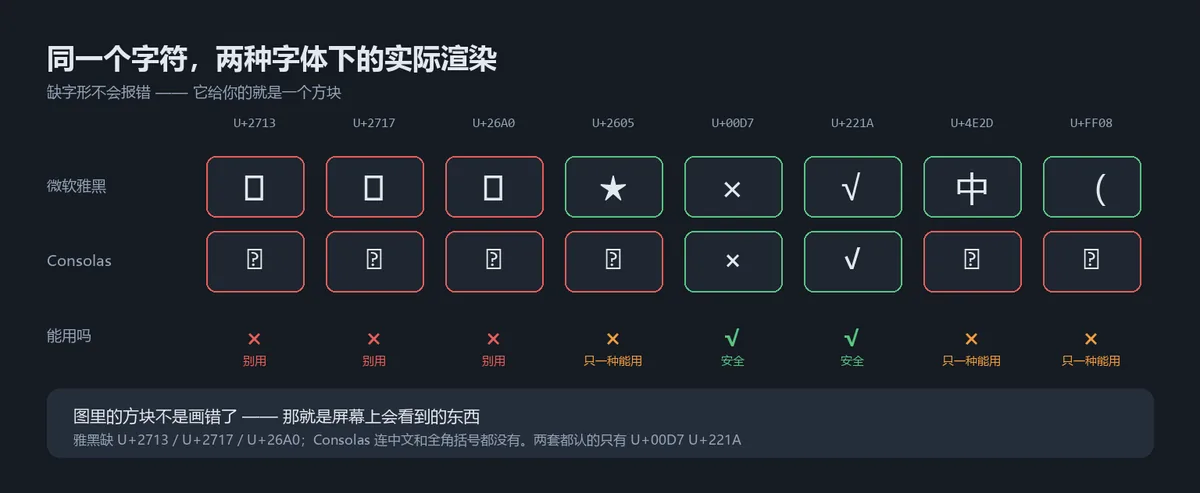
最后两行就是答案:×(U+00D7)和 √(U+221A)在两套字体里都有字形, 而且中文标点里本来就常用。换掉就没问题了。
(这个结论是我把字符渲染成图、打开看才确认的。查文档没用 —— 文档只会告诉你「微软雅黑支持中文」,不会告诉你它不支持 ✓。)
后来画列宽示意图,我想找个符号表示空格,用了 U+2423 —— 两套字体也都没有它。 同一个坑,隔了一天又踩一次。最后换成了 ·。
坑三:不画方块的那个,更难发现
前两个坑都表现为方块,一眼能看见。第三个不一样。
给 nginx 的 return 为什么会绕过 location 那篇画阶段图时, 要在表格里并排放 返回 403 和 return 403。 结果整张表斜着歪掉了 —— 不是错一格,是越往右越歪。
原因不复杂:等宽字体里一个汉字占两格。len() 按字符数算, 但渲染时中文占的宽度是英文的两倍。按字符数排的表格,中文一多就集体右移。
所以宽度得按「等宽列数」算:
def is_cjk(ch):
    o = ord(ch)
    return (0x2E80 <= o <= 0x9FFF      # 汉字
            or 0xFF00 <= o <= 0xFFEF   # 全角
            or 0x3000 <= o <= 0x303F   # 中日韩标点
            or 0x2000 <= o <= 0x206F)  # 破折号等

def mixed_len(s, cjk_width=2):
    """按等宽字符数算宽度(CJK 算 2 列)"""
    return sum(cjk_width if is_cjk(c) else 1 for c in s)
配套还有两件事:用 wrap_mono() 按列数自己换行(别指望 PIL 的自动换行, 等宽字体下它不可控),以及画之前先算好面板高度,否则文字会压到边框上。
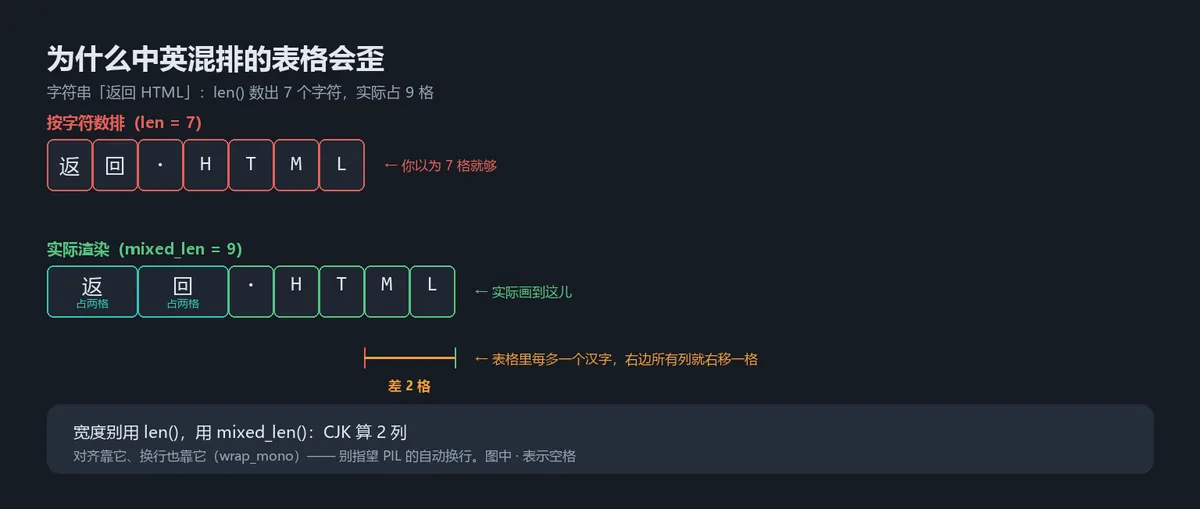
想更彻底的话,可以逐字符分派字体。ASCII 走 Consolas、中文走雅黑, 每个字符的 x 坐标自己累加:
def text_mixed(d, xy, s, font_ascii, font_cjk, fill=TXT, cjk_width=2):
    adv = d.textlength("M", font=font_ascii)   # 等宽步进
    x, y = xy
    for ch in s:
        f = font_cjk if is_cjk(ch) else font_ascii
        d.text((x, y), ch, font=f, fill=fill)
        x += adv * (cjk_width if is_cjk(ch) else 1)
中文可见,ASCII 严格等宽。代价是每个字符一次 d.text(), 一张图几千个字符会慢一点 —— 但画图是一次性的,无所谓。
三个坑其实是同一件事
回头看,共同点是:字体覆盖是个黑盒,你只能试。
- Consolas 有
×,没有✓ - 雅黑有
★,没有⚠ √两边都有;全角括号只有雅黑有
没有哪份字体文档会告诉你这些。而且缺字形不报错,就是给你一个方块。
所以留了一条判断标准:
这个字符在中文正文里常见吗?常见才安全。
× √ → 常见,能用。✓ ✗ ⚠ 是 Dingbats 区的,中文环境本来就少见 —— 不确定就写文字(「错误」「正常」),别赌字体里有没有。
还有一条工作习惯:画完必须打开图看一眼。 这类错不进日志、不抛异常,唯一的发现方式就是看。
怎么查自己的字体缺什么
看太慢。缺字形的字符有个特征:它们渲染出来的位图,和私有区字符一模一样 —— 都是那个方块。拿私有区当参照,就能批量筛。
# glyph_check.py —— 排查字体缺哪些字形
from PIL import Image, ImageDraw, ImageFont

REF = "\ue000"          # 私有使用区:正常字体都没有,拿它当「缺字形」参照

def sig(font, ch):
    im = Image.new("L", (80, 80), 0)
    ImageDraw.Draw(im).text((10, 10), ch, font=font, fill=255)
    return im.tobytes()

for path in ("C:/Windows/Fonts/msyh.ttc", "C:/Windows/Fonts/consola.ttf"):
    f = ImageFont.truetype(path, 40)
    ref = sig(f, REF)
    missing = [c for c in "✓✗⚠★×√" if sig(f, c) == ref]
    print(path, "缺:", "".join(missing) or "无")
跑一下:
python glyph_check.py输出:
C:/Windows/Fonts/msyh.ttc 缺: ✓✗⚠
C:/Windows/Fonts/consola.ttf 缺: ✓✗⚠★
把 "✓✗⚠★×√" 换成你要用的字符就行。换服务器上的字体路径,同样能查 Linux 字体。