5118 导出十个 CSV,丢给 WorkBuddy 跑一遍:一句指令,五个结果文件,一份 260KB 的 HTML 报告,十张图,十项校验全绿。
然后我发现它从第一行数据起就读错了。
报告是好的,数据是错的
先说怎么用。不用装软件,也不用背命令——把 5118 导出的目录和 IP 名字告诉它就行,剩下的它自己认:
分析 D:\挖词\某剧5118挖词,IP 名 《剧名》,出蓝海词报告换成别的剧、别的综艺,改目录和 IP 名就行。
问题出在读文件这一步。5118 的导出不是标准表格:第一行是文件名,第二行才是表头,而且数据行比表头多一列——末尾跟着个空列。
我定的规则翻译成人话是:开头四行里谁占的列最多,谁就是表头。代码就一行:
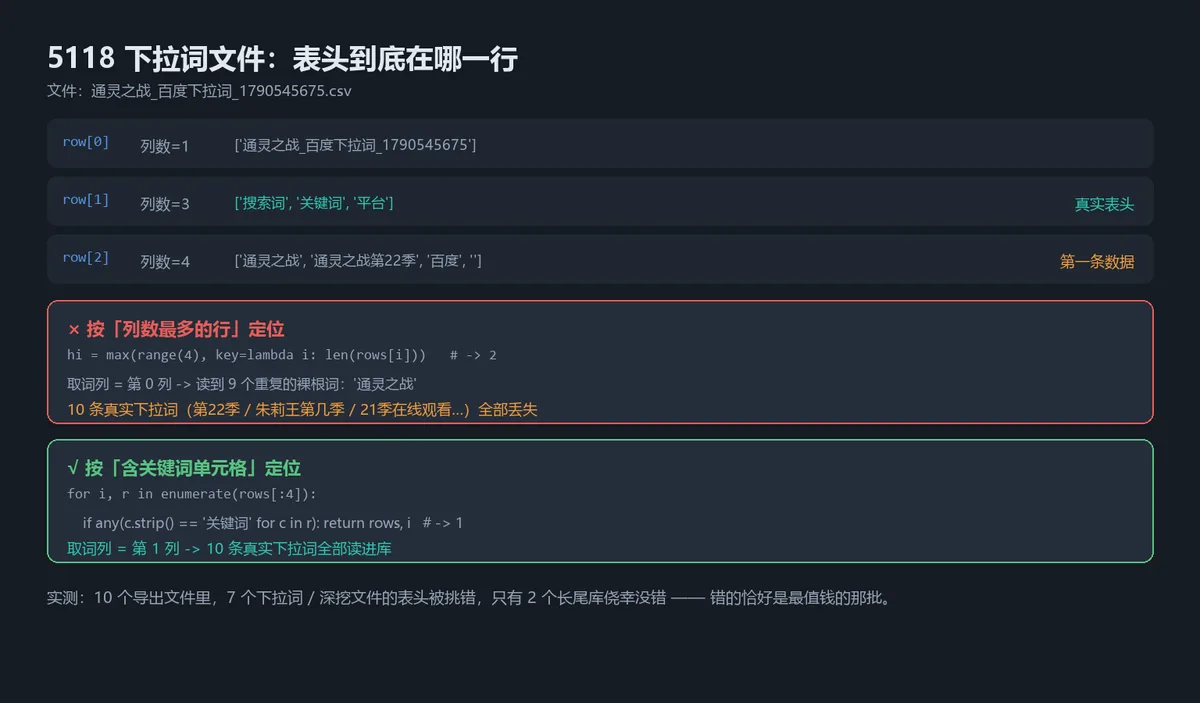
hi = max(range(min(4, len(rows))), key=lambda i: len(rows[i]))听着挺合理,跑起来也不报错。拿百度下拉词那份文件实测,它选中了 row[2],也就是第一条数据:
row[0]  列数=1  ['通灵之战_百度下拉词_1790545675']
row[1]  列数=3  ['搜索词', '关键词', '平台']
row[2]  列数=4  ['通灵之战', '通灵之战第22季', '百度', '']
表头变成了一条真实数据,取词的列自然落到第 0 列。于是这份文件里十条真实下拉词一条都没进来,读进去的是:
['通灵之战', '通灵之战', '通灵之战', '通灵之战', '通灵之战', '通灵之战', '通灵之战', '通灵之战', '通灵之战']九个一模一样的裸词。真正有价值的那批——通灵之战第22季、通灵之战朱莉王第几季、通灵之战21季在线观看完整版——全丢了。
小红书深挖那份中毒更深。它的表头行只有一列,写着「关键词」;而文件名那行被当成表头选中,读出来的第一个"词"就是关键词这三个字。它会被当成一个真实搜索词,乖乖进评分、进图表。
改成什么
别数列数了,直接找带「关键词」这三个字的那行——它在哪行,哪行就是表头。代码就三行的意思:
for i, r in enumerate(rows[:4]):
    if any(c.strip() == '关键词' for c in r):
return rows, i改完我顺手把十个文件全验了一遍——本来以为只有下拉词这份出事,结果七个下拉词和深挖文件的表头都被挑错了,两个长尾库侥幸没事(它们的数据行列数恰好等于表头)。
也就是说,错的恰好是最值钱的那批。下拉词是真人一个字一个字敲出来的,比机器扩出来的长尾可信得多,而它们一条都没进库。
另一个更阴的坑
这个跟文件格式无关,是统计口径的事。
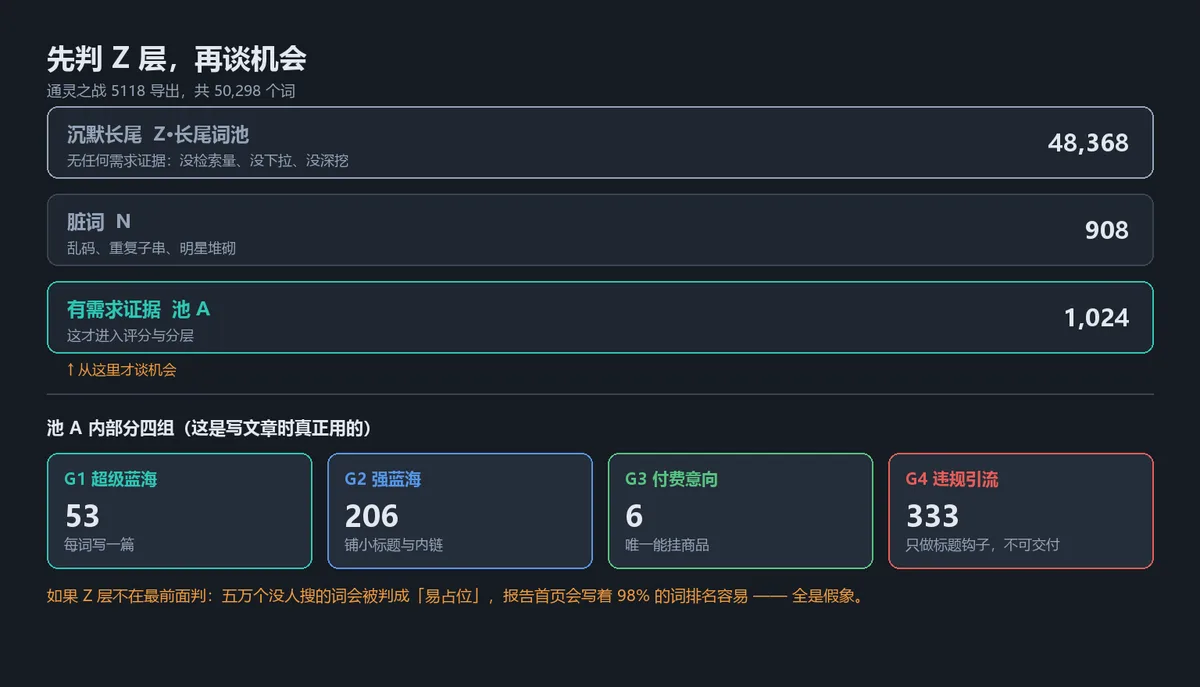
五万个词里真正有需求证据的只有一千出头,剩下五万全是沉默长尾:没检索量、没进过下拉,什么信号都没有。我最初把"没人跟你抢"直接当成"容易排上去",于是这五万个没人搜的词集体被判成"易占位"。报告首页写着 98% 的词排名容易——看着全是机会,其实全是没人去的沙漠。
修法是在所有机会层之前,先加一道筛:这个词到底有没有被搜过。没有,就直接扔进 Z·长尾词池,不参与排名判断。排名档位的第一个分支也得是"无需求证据"。不为别的,就为了那些沉默词别混进统计。
这类隐蔽错误有个共同点:当时不算错,隔很久才显形。上一次让我吃这个亏的是三个月前埋的 nginx 规则,证书到期那天才炸,详见网站突然提示证书不受信任?三个月前埋的雷,今天炸了。
现在怎么跑
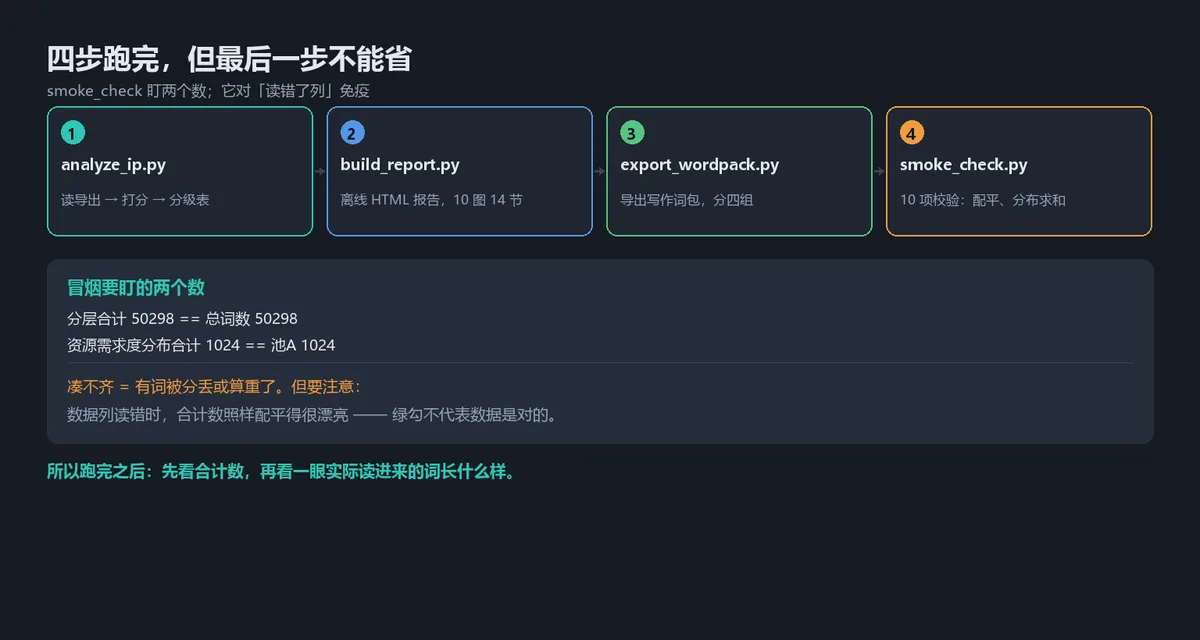
看不懂 Python 也没关系——这些脚本是给它自己用的,不是给你写的。真想自己复核,四步:
python analyze_ip.py    --src "src" --name "NAME" --out "out"   # 打分分级
python build_report.py  --data "out/report_data.json" --name "NAME" --out "out/报告.html"
python export_wordpack.py "out" --name "NAME"                    # 导出写作用的词包
python smoke_check.py   "out"                                    # 校验,别省
第三步导出的是写作用的词包,按"能不能写、能不能卖、要不要提醒"分四组,比翻五万行表格省事。
最后那个校验,我只盯两个数:分层加起来等不等于总词数、几个分布对不对得上。它抓到过一次:
分层合计 50298 == 总词数 50298
资源需求度分布合计 1024 == 池A 1024这是数据自洽的最低标准——凑不齐,说明有词被分丢或者算重了。但得说清楚:它对"列读错了"这种错完全免疫。数据读错,合计数照样配平得很漂亮。绿勾不代表数据是对的。
怎么发现问题的这一步,说白了跟那 61 次「百度蜘蛛」,其实是我自己是同一个动作:别信工具给你的总结,回到原始数据上看一眼。
还有个没解决的问题
这批数据我到现在也没法拿它估真实需求规模。5118 共享号只解锁了 66 个词的实测检索量,合计 170 次/天,这个量级说明不了任何规模问题,只能看结构和相对大小。
这批人的代表性够不够我没深究,权当抽样看。反正结论是相对的:一千个有效词里能放心变现的只有六个,剩下的要么查信息,要么碰版权。
跑完别急着发。先看合计数,再看一眼读进来的词长什么样。