先说结论:提交死链不是关开关。 你只是把一份清单交上去,百度什么时候处理、处理完会不会立刻停,都不归你管。还有一个容易忽略的:日志里"还在抓死链"的,未必都是百度。
9 月 28 号晚上我把 deadlinks.txt 部署上线 —— 10 条 URL,每条都实测过 404 —— 然后去站长平台提交了。
过了 8 天。10 月 6 号早上翻日志,里面还挂着两条。隔几分钟来一次。
日志里那几行
按百度官方 IP 段过滤,只看 220.181. 和 116.179.,10 月 6 号早上是这样:
[06/Oct/2026:06:20:17 /tag/2025%E7%94%9F%E6%B4%BB%E5%B0%8F%E5%A6%99%E6%8B%9B 404
[06/Oct/2026:06:21:45 /author/1/page/2157 404
[06/Oct/2026:06:23:42 /tag/2025%E7%94%9F%E6%B4%BB%E5%B0%8F%E5%A6%99%E6%8B%9B 404
[06/Oct/2026:06:27:02 /author/1/page/2157 404
[06/Oct/2026:07:23:50 /tag/2025%E7%94%9F%E6%B4%BB%E5%B0%8F%E5%A6%99%E6%8B%9B 404
[06/Oct/2026:07:38:00 /tag/2025%E7%94%9F%E6%B4%BB%E5%B0%8F%E5%A6%99%E6%8B%9B 404
六次,两条,全在死链清单里。IP 是不是真的,反查 PTR 说了算:
host 220.181.108.159
# 159.108.181.220.in-addr.arpa domain name pointer
# baiduspider-220-181-108-159.crawl.baidu.com.
带 crawl.baidu.com 的才是真蜘蛛。UA 一律不信,那个能随便改,我之前踩过。
第一个坑:抓死链的还有我自己
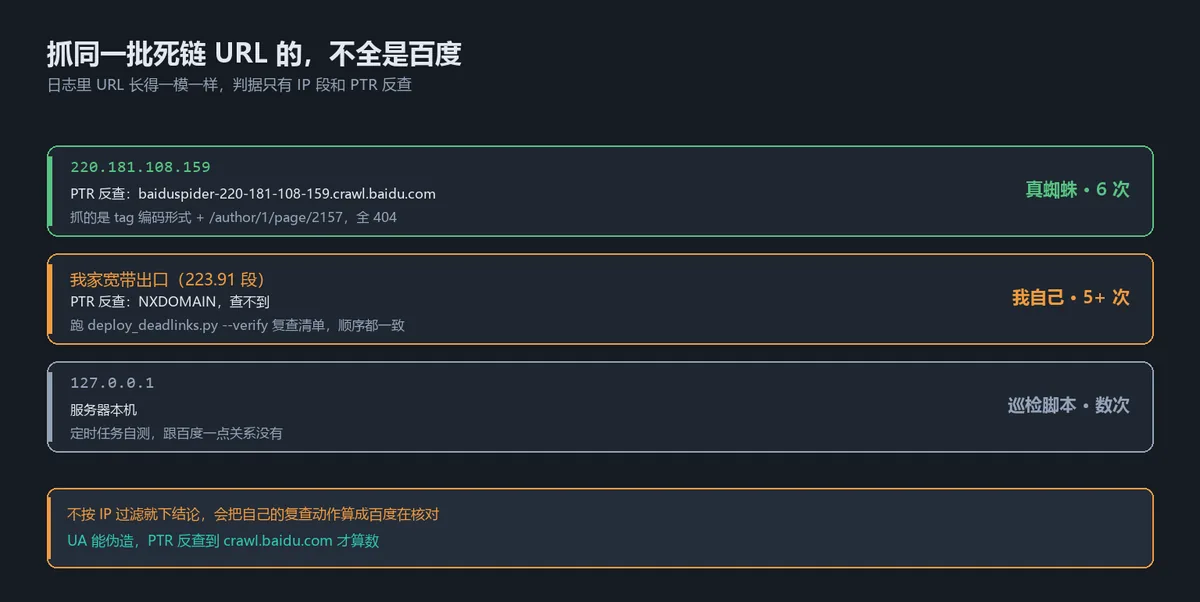
比上面那六次更密的,是 06:18 那批 —— 一分钟里连着抓了 /author/1、那个 tag、/author/1/page/1501、/1499、/906、/2157,顺序跟我的清单几乎一模一样。
我第一反应是"百度拿着我的清单在逐条核对"。差点就这么写进结论。
去对 IP 才反应过来:那批不是百度。 请求来自一个 223.91 段的家宽 IP,PTR 查不到东西,跟我登录后台用的是同一个段 —— 是我自己在跑 deploy_deadlinks.py --verify,复查这些 URL 还返不返回 404。服务器本机也抓了一批,那是我的巡检脚本。
这个判断我没法 100% 坐实。只能说 IP 段、访问顺序、时间点三条都对得上我的复查动作。
所以日志里"抓死链"这件事,百度只占一小半。光看 URL 长得像就下结论,很容易给自己加戏。
第二个坑:我以为编码对不上,其实一字不差
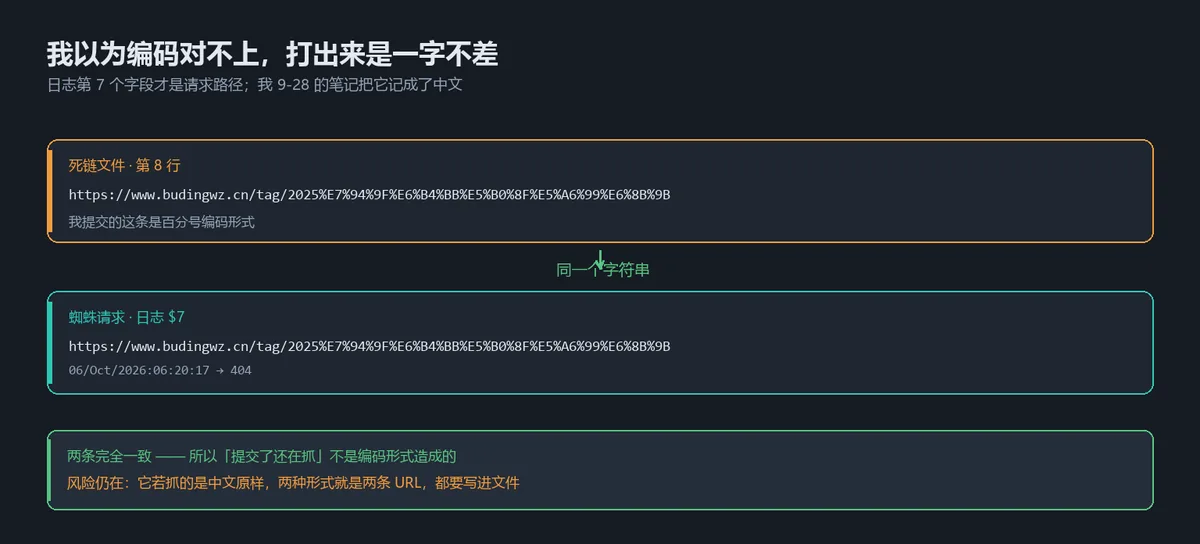
我本来准备写"文件里提交的是百分号编码,百度抓的是中文原样,两条在它眼里不是同一个 URL"。这个说法听着很成立 —— 我 9 月 28 号的笔记里,那条日志就记成了 /tag/2025生活小妙招。
这次把日志原样打出来:
grep -E '220\.181\.|116\.179\.' 站点日志 | awk '{print $7}' | sort | uniq -c第 7 个字段是请求路径,打出来是 %E7%94%9F%E6%B4%BB%E5%B0%8F%E5%A6%99%E6%8B%9B,跟死链文件第 8 行一个字符都不差。当初是我把编码后的东西看成中文,记错了。
不过这个坑本身没消失:万一它抓的真是中文原样,而你只提交了编码形式,那就是两条 URL。稳妥做法是两种形式都写进去,中文那条放文件最后 —— 万一解析器遇到非法字符中断,也不会连累前面的行。
那它为什么还在抓
URL 对得上,文件也交了,剩下的原因都不在我这边。
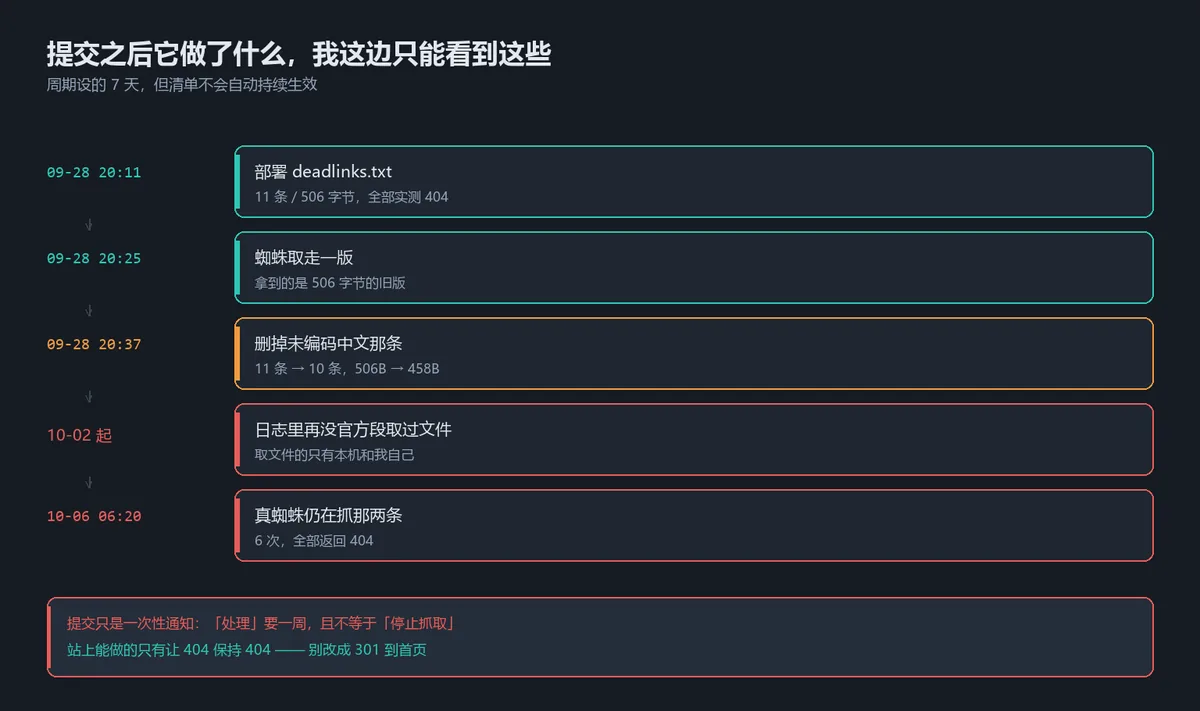
一是它不一定还在看那份文件。 我把更新周期设成 7 天,指望它定期来取。翻 deadlinks.txt 自己的访问记录:
grep 'deadlinks' 站点日志 | awk '{print $1, $4, $9}'127.0.0.1 [02/Oct/2026:06:47:05 /deadlinks.txt 200
<我家宽带 IP> [04/Oct/2026:09:46:48 /deadlinks.txt 200
<我家宽带 IP> [04/Oct/2026:09:46:51 /deadlinks.txt 200取过文件的只有服务器本机和我自己。官方段一次都没来过。 文件本身是好的:
curl -s -o /dev/null -w '%{http_code} %{size_download}\n' https://你的域名/deadlinks.txt
# 200 458
二是"生效"说的是它处理提交,不是它停止抓取。 百度自己的说法是一周。这一周里它按自己的队列来确认,亲眼见了 404 才肯放手。我看到的这六次,可能正是它在核对 —— 只是站在我这边看,就是"交了还在抓"。至于它内部怎么排这个队列,这块我没深究,也说不上来。
还有个打架的信号:robots.txt 里我给 Baiduspider 单独写过一段,那段不继承前面的 Disallow: /author/,等于把 /author/ 对百度重新开门。死链说别来,robots 说欢迎来。这个坑上一篇写过,10 月 6 号早上已经把那段删掉了 —— 上面那六次抓取发生在删之前。
删完之后它再来,理论上会被 robots 挡在门外。但新日志我还没看到,不敢打包票。和推送成功不等于收录一个道理 —— 这类事你得去对方侧查,自己这边的"提交成功"说明不了后面的动作。
站上能做的只有一件,而且别做反:该 404 的就让它 404,不要为了"消灭死链"把这些 301 到首页,那是软 404,比 404 更糟。