先说结论:robots.txt 里给 Baiduspider 单独开一段之后,User-agent: * 那段写的屏蔽,对百度一条都不生效。
我这个文件里 * 段明明白白写着 Disallow: /author/。可日志里百度正在抓 /author/1/page/2157,返回 404。
日志里那行字
220.181.108.159 - - [06/Oct/2026:06:21:45 +0800] "GET /author/1/page/2157 HTTP/2.0" 404 9792 "-" "Mozilla/5.0 (compatible; Baiduspider/2.0; +http://www.baidu.com/search/spider.html)"十分钟后又来一次,换了个 IP,换了个手机 UA,还是同一个 URL,还是 404。
这个 IP 段值得认一下。220.181. 开头属于百度官方段,那 61 次「百度蜘蛛」,其实是我自己那篇里已经踩过一次:UA 谁都能改,IP 段改不了。这两条记录是真的。
我先怀疑了两件事,都错了
第一反应是蜘蛛造假。同一轮盘日志时我刚揪出一批伪装成 Baiduspider 的扫描器,全来自同一个云服务器 IP,在扫 /.env、/api/config 这类漏洞路径。但按官方段把真蜘蛛挑出来之后,那两条 /author/ 的记录就在里面,跑不掉。
第二个怀疑是文件压根没被读到。curl 一下:
curl -s --resolve 你的域名:443:127.0.0.1 -o /dev/null -w '%{http_code}' https://你的域名/robots.txt200,317 字节,跟我以为的内容一字不差。文件也没问题。
它只听叫自己名字的那一段
把文件摊开看:
User-agent: *
Allow: /
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /wp-includes/
Disallow: /*?s=
Disallow: /*?replytocom
Disallow: /search
Disallow: /attachment/     ← 我屏蔽了
Disallow: /author/         ← 我屏蔽了

User-agent: Baiduspider
Allow: /
Disallow: /wp-admin/
Disallow: /*?s=

Sitemap: https://你的域名/sitemap.xml
robots.txt 不是从上往下叠加的。爬虫进来先找名字最匹配自己那一段,找到之后就只认这一段,其余全部丢掉。百度看到 Baiduspider,眼里只剩那三行。
那三行里没有 /author/,也没有 /attachment/。所以在它看来是放行的。
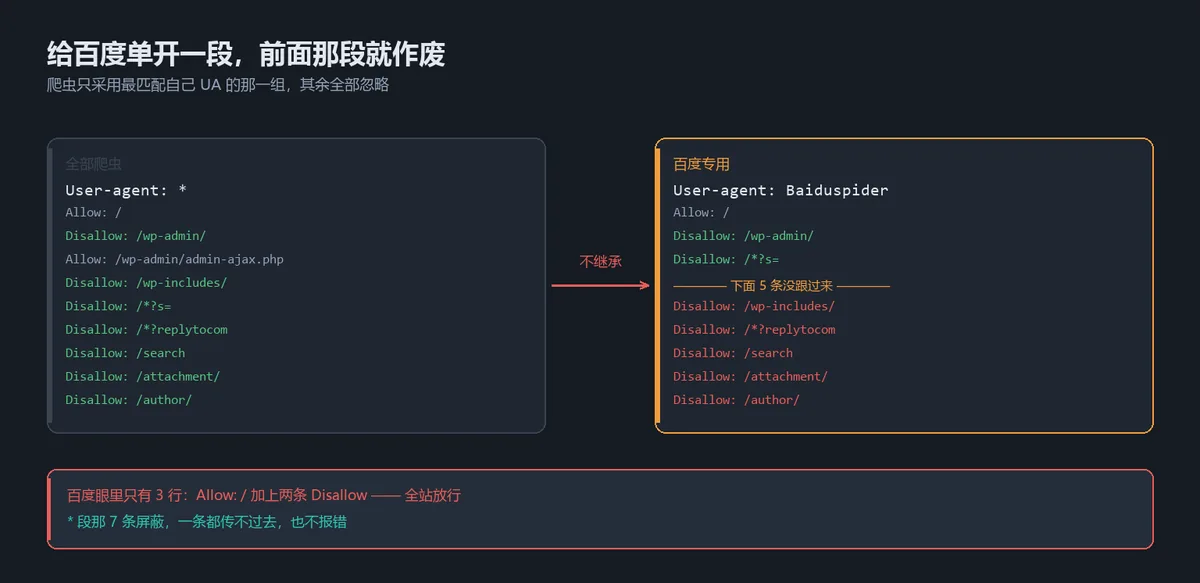
现在回头看,最扎人的是当初写它的动机 —— 想的是“给百度稍微松一点”。松是松了,顺手把明确屏蔽过的聚合页一起放开了。
六次访问,五次落在我不想让它抓的地方
把真蜘蛛的记录按路径数一遍:
grep -E '220\.181\.108\.|116\.179\.32\.' 站点日志 | grep -oE 'GET [^ ]+' | sort | uniq -c | sort -rn 3 GET /tag/2025%E7%94%9F%E6%B4%BB%E5%B0%8F%E5%A6%99%E6%8B%9B
2 GET /author/1/page/2157
1 GET /一共 6 次,只有 1 次抓的是首页。剩下 5 次全是聚合页:标签页 3 次、作者分页 2 次 —— 作者页正好是我在 robots.txt 里明确屏蔽过的那类。而且全是 404。
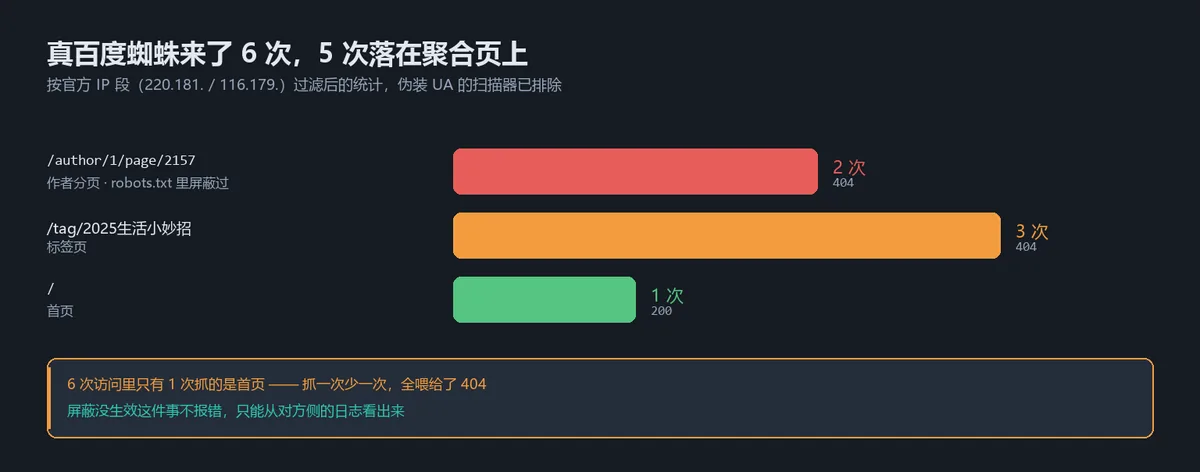
站点上线第 9 天,日志四万七千行,真蜘蛛就这 6 次。抓一次少一次,全喂给了 404。
两种改法,我选了删掉
一是把 * 段的屏蔽在 Baiduspider 段里原样抄一遍。能解决,但以后每加一条都得记着改两处,这种靠人记住的约定迟早漏一次。
二是直接删掉 Baiduspider 这一段。动手前我把两段逐条对了一遍:* 段有 7 条 Disallow,百度段只有 2 条,是它的子集。也就是说这一段唯一多做的一件事,是解除剩下的五条 —— /author/、/attachment/、/search、/wp-includes/、/*?replytocom。没有一条是“额外加上”的。
删之前先确认文件里到底有几段,别只看了开头就下手:
grep -n '^User-agent' 站点根目录/robots.txt删完百度就去吃 * 段,屏蔽项全部生效。改完用百度 UA 拉一遍文件,317 字节变成 246 字节,少的那 71 字节就是删掉的那一段 —— 数字对得上,才算真删了。
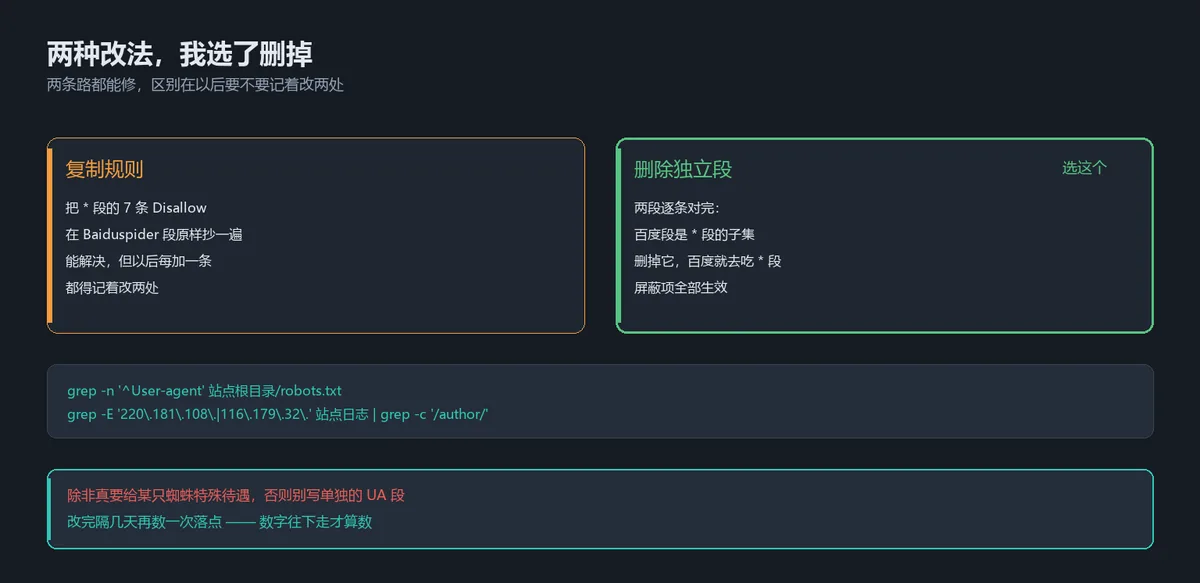
结论就一句:除非你真打算给某个爬虫特殊待遇,否则别写单独的 UA 段。 写它就是在解除前面写好的屏蔽,而且不报错、不提示,只能靠日志发现。
改完别急着信。robots.txt 不是即改即生效,爬虫会缓存它,得等下次来重新读;已经抓过的 404 也不会因为它改了就消失。要验,隔几天再数一遍真蜘蛛有没有再碰 /author/:
grep -E '220\.181\.108\.|116\.179\.32\.' 站点日志 | grep -c '/author/'数字得往下走才算数。光盯自己这边的配置文件,是什么都看不出来的 —— 脚本发了 6 篇,百度一篇没收到那篇栽的就是同一件事。
robots 这一层我前后栽过两次。上一次是一页两个 robots 标签,百度该听谁的,毛病一模一样:规则的信号自己打架,页面照常 200,校验脚本还判通过。
/author/1/page/2157 这个 2157 我到现在也没搞明白。站上一共十来篇文章,作者分页不该有两千多页。这块我没深究。把百度那段删掉之后,它该被挡住了。