先说结论:想让百度别收录某些页面,别用 403 拒蜘蛛,在响应头里加一行 X-Robots-Tag: noindex。 403 看着利索,实际是拿主站权重换的。
起因是我手里有一批子站——工具页、跳转页,内容跟博客主站完全不搭。需求就一句话:人照常访问,百度别收录。
「人照常访问」这半句,先排掉了 return 444 直接断连接的方案——那是给没人用的随机子域准备的,另说。剩下就是网上随处可见的教程写法:
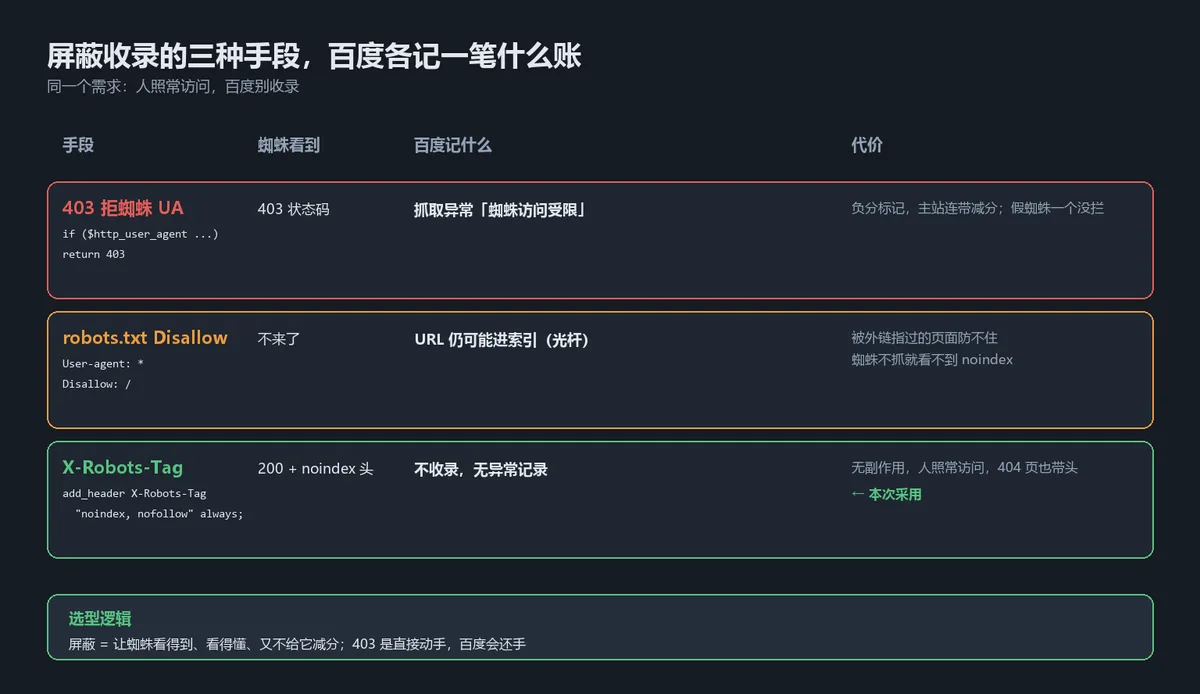
if ($http_user_agent ~* Baiduspider) {
    return 403;
}
对蜘蛛 UA 返回 403,人不受影响。
我考虑过这段配置,最后没用,两个原因。
一是百度对 403 不是「默默不收录」。抓取异常会记进站长平台,「蜘蛛访问受限」是个负分标记。子站和主站在同一个站长账号下——为了几个子站给主站埋雷,这买卖不划算。
二是 UA 根本靠不住。之前查抓取日志,UA 写着 Baiduspider 的请求,大部分是假的:有本机发的,有家宽 IP 伪装的,真蜘蛛要按官方 IP 段反查(那 61 次「百度蜘蛛」,其实是我自己)。按 UA 拦,真蜘蛛被拦在门外还记一笔异常,假蜘蛛一个没拦——它不守你的规矩,还替你把内容广播出去。
robots.txt 写 Disallow: / 呢?挡得住抓取,挡不住收录:URL 只要被外链指过,仍会以光杆形式进索引。而且蜘蛛不来抓,页面上写什么它都看不见。
最后用的是这一行:
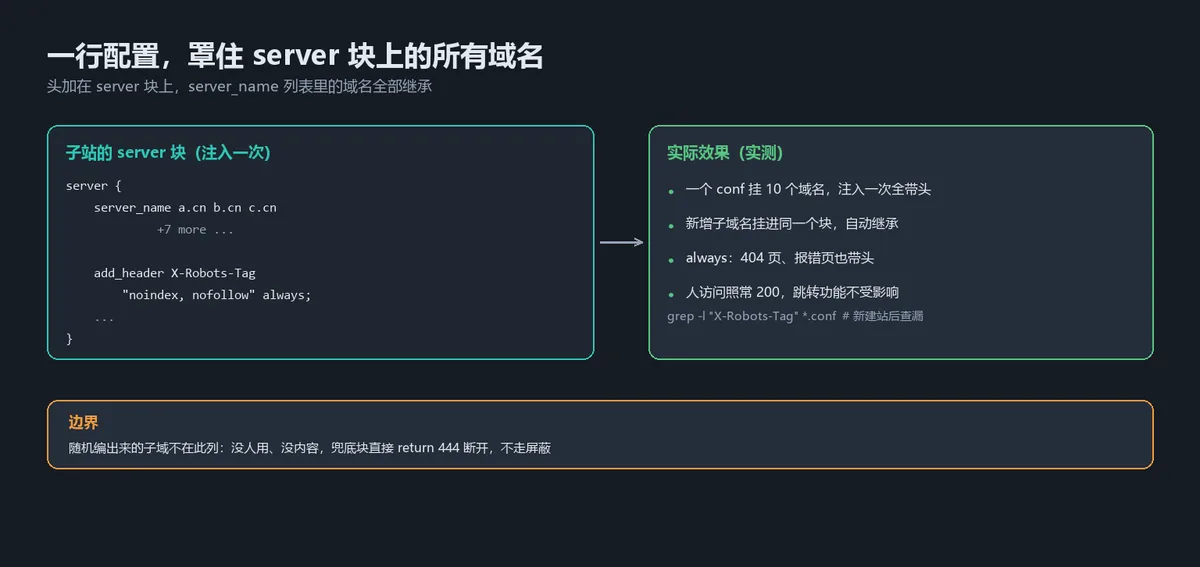
add_header X-Robots-Tag "noindex, nofollow" always;放在子站的 server 块里。语义变了:页面照常 200 给你看,响应头里带一句「请别收录」。百度认这个头,不记任何异常。
always 别漏。
add_header 默认只在正常响应生效,404 页是不带的——屏蔽站上偏偏一堆 404,漏了它等于留了个后门。响应头还有个好处:PHP、静态文件、报错页全罩住,不用改一行业务代码。
还有个意外收获:头是加在 server 块上的,对这个块 server_name 列表里的所有域名一次生效。我有个 conf 挂了 10 个域名,原本以为得逐个补,复查时才发现注入一次就全覆盖了。新增子域名只要挂进同一个块,自动继承。
子站根目录我还放了 robots.txt 写 Disallow: /,当双保险。严格说这层和 noindex 头是打架的:蜘蛛遵守协议不来抓,就看不到响应头里的 noindex。留着它的理由是万一哪天 nginx 配置被面板覆盖,robots.txt 还在。这块我没深究。robots.txt 的分段规则另有坑,单独写过(robots.txt 给百度单独放行,前面的屏蔽全作废)。
验证两条命令:
curl -sI https://你的子站域名 | grep -i x-robots-tag
grep -l "X-Robots-Tag" /www/server/panel/vhost/nginx/*.conf
实测响应头带 X-Robots-Tag: noindex, nofollow,页面 200,站上的跳转功能一点没受影响。新建子站后跑一眼第二条,能当场抓出漏网的——我就这么抓出过两个没走屏蔽流程的新站。
顺带说清边界:随机编出来的子域名不配这么客气。那种域名没有真实用户,兜底 server 块直接 return 444 断连接,干净利落——这是另一码事,写在前面的泛解析那篇里。
蜘蛛来一次,看见 200,看见 noindex,转身走人,你一分不扣。
比对着 UA 拦人省心多了。