先报数:上线第 9 天,百度收录 0 篇。
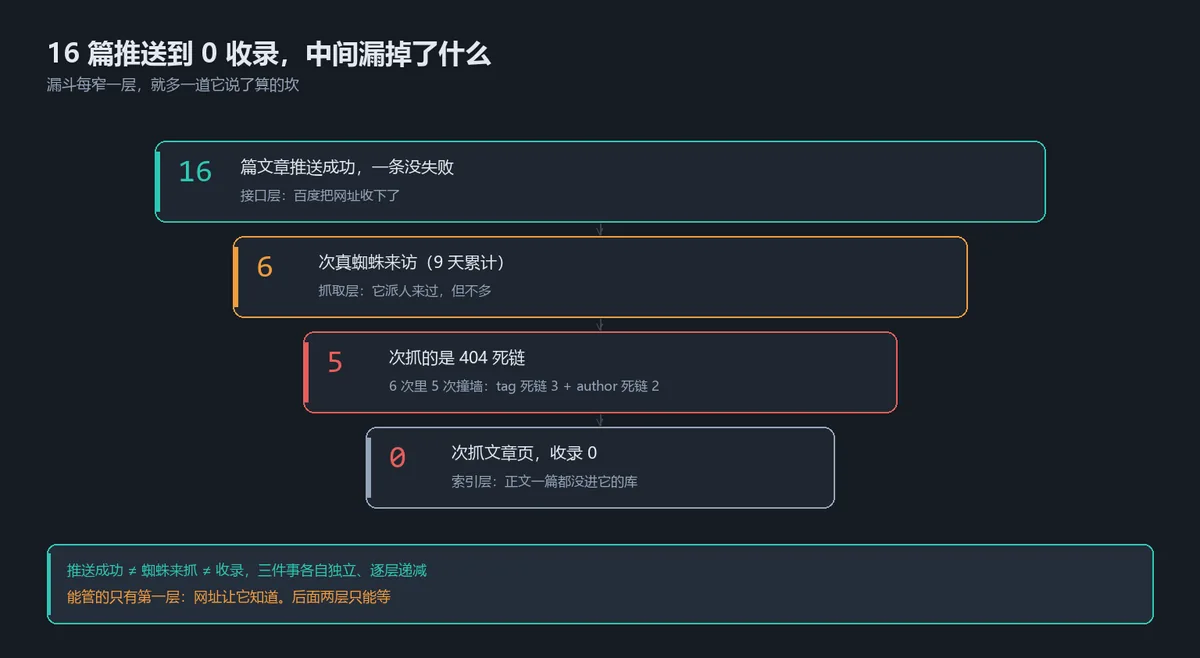
推送记录倒是很体面——16 篇全部推送成功,一条失败都没有。蜘蛛也来过,9 天一共 6 次。但这 6 次里,没有一次抓的是文章页。
这 9 天干了什么、查到了什么数,全在这篇里。等收录那天回来对照,正好知道新站这段干等的日子到底有多长。
第 1 天到第 9 天,时间线是这样的
9 月 28 日上线。当天把能配的都配了:推送接口、sitemap、站长平台验证。
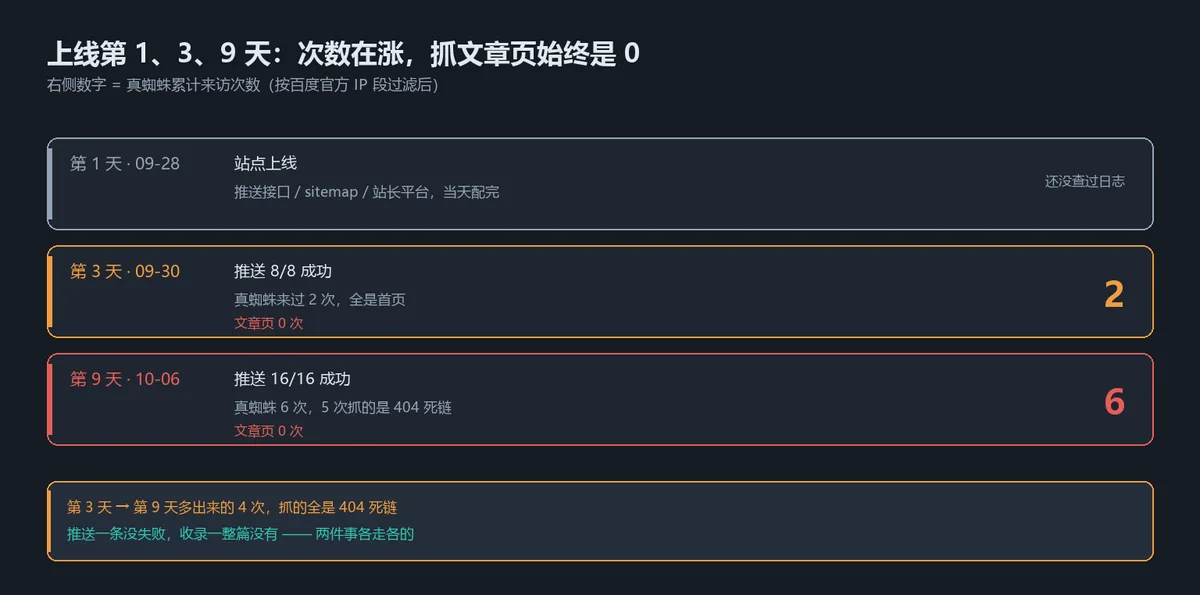
9 月 30 日(第 3 天)第一次翻服务器日志。真蜘蛛来过 2 次,全是抓首页。当天站上 8 篇文章,推送记录 8 篇全成功。
10 月 6 日(第 9 天)再查:日志涨到四万七千多行,真蜘蛛一共来过 6 次。
比第 3 天多了 4 次——听着像好事,往下看就知道不是。
先排掉一个坑:自称百度蜘蛛的不一定是百度
服务器日志里,每条访问都带一串"自我介绍",说明自己是什么来头。蜘蛛的那串字里写着 Baiduspider。
我头一回数的时候还挺高兴——自称蜘蛛的有 11 条,天天都来啊。
我以为这 11 条都是百度,对着来源 IP 一数才发现:真的只有 6 条,剩下 5 条来自同一台云服务器,伪装的。它在扫我站的漏洞文件,顺便把自己介绍成了蜘蛛。
数一遍真伪,两行命令的事:
# 自称蜘蛛的一共多少条
grep -c 'Baiduspider' 站点日志
# 按来源 IP 分组,谁在冒充一眼就看出来
grep 'Baiduspider' 站点日志 | awk '{print $1}' | sort | uniq -c
220.181 开头的 IP 才是百度自家机房的,其他开头的默认当冒充处理。
总不能是我家宽带抓的吧。这坑我之前栽过更大的:日志里 61 次"百度蜘蛛",其实全是我自己。怎么分出来的写在这篇里。
6 次来访,抓的都是什么
把真蜘蛛的访问从日志里捞出来,按它抓的网址分组:
grep -E '220\.181\.|116\.179\.' 站点日志 \
  | awk '{print $7}' | sort | uniq -c | sort -rn
(每行日志按空格切开,第 7 段是它要抓的网址,awk 负责把这一段取出来数。)
      3 /tag/2025%E7%94%9F%E6%B4%BB%E5%B0%8F%E5%A6%99%E6%8B%9B
      2 /author/1/page/2157
      1 /
3 次抓一个标签页,2 次抓一个作者分页,1 次抓首页。第一行那串百分号开头的,是网址里中文的编码写法,不是乱码。
关键是:前两个地址在我站上根本不存在,全是返回 404 的死链接。蜘蛛来了 6 次,5 次全喂给了打不开的页面。
它不是不来,是来了全撞墙。
这批死链我上线当天就提交给百度了,它照样来抓——提交死链不等于它马上停手,这事之前写过。至于它当初从哪记下这两个死地址的,我没深究,估计是顺着什么链接爬到的。
推送 16 篇全成功,和收录 0 篇,矛盾吗
不矛盾,中间隔着好几步。推送成功只是百度把网址记下了;记下之后派不派蜘蛛来、抓完建不建索引,都不归我管,也不会通知我。
第 3 天那会儿我一度怀疑推送是假成功——按钮显示成功了,实际请求根本没发出去。这种坑我真踩过,见推送显示成功,请求 0 次那篇。
真去查了才确认:配额从 8 递减到 0,这个数是百度服务器原样回的,推送是真的。
真不真都一样——它真收下了 16 个网址,然后 9 天没来抓过一篇正文。推送和收录这两层怎么分开验,百度推送成功不等于收录那篇写得更细。
等的这几天,能做的就三件
一,推送照推。配额每天清零重置,不用就浪费了。
二,死链保持 404,别改成 301 跳回首页。404 是明确信号,蜘蛛知道这页没了。
三,文章照发。它现在不来抓,不代表不记账。
别的真没了。第 10 天上午,推送接口开始被百度限流,回的话是 please retry later——连推送通道都得看它脸色,急也没用。
第 9 天就是这些:来访 6 次,5 次 404,收录 0。数据放在这了,下次更新不知道是第几天——它哪天来抓正文,我哪天接着写。