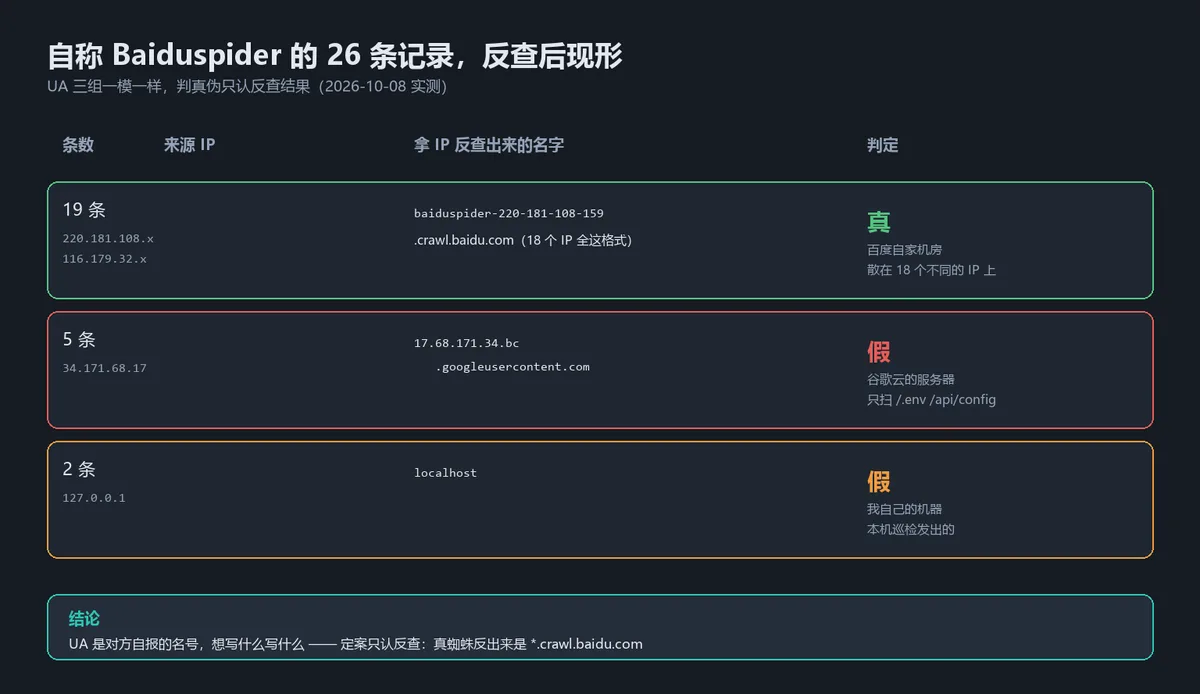
先说结论:UA 验不出蜘蛛真假,拿 IP 反查域名才行。今天早上我把日志里自称 Baiduspider 的记录全捞了一遍,一共 26 条。按 IP 一分:19 条真,7 条假。那 5 条最像的,是谷歌云的服务器冒充的。
自称蜘蛛的 26 条,7 条是假的
UA 就是每条日志末尾那串"自我介绍"。蜘蛛来抓的时候会报上名号,正常长这样:
Mozilla/5.0 (compatible; Baiduspider/2.0;
+http://www.baidu.com/search/spider.html)
问题是这个名号谁都能报。我不死心,拿 curl 亲手试了一次——一行命令,我的服务器就把这台"百度蜘蛛"老老实实记进了日志:
$ curl -A "Mozilla/5.0 (compatible; Baiduspider/2.0;
+http://www.baidu.com/search/spider.html)" https://你的站/
写爬虫的连 curl 都不用,一行代码的事。所以 UA 只够用来筛出嫌疑人,不够用来定案。
26 条嫌疑人按 IP 分组是这样:
19 条  220.181.108.x / 116.179.32.x   ← 百度自家机房
 5 条  34.171.68.17                    ← 一台云服务器
 2 条  127.0.0.1                       ← 我自己的机器
19 条真蜘蛛,来自 18 个不同的 IP。抓取机器那个池子到底多大我没查证过,反正一天之内 18 个 IP 是亲眼数的。
那台 34.171.68.17 的 5 条,抓的东西先露了馅:
GET /api/config
GET /api/v2/config
GET /images../.env没有一条是正常页面。/.env 是配置文件,里面经常放着数据库密码——这是在扫漏洞。
反查一秒现形:谷歌云的机器
给每个嫌疑 IP 反查域名(把 IP 换成注册时登记的名字),真假立现:
$ host 220.181.108.159
159.108.181.220.in-addr.arpa domain name pointer
    baiduspider-220-181-108-159.crawl.baidu.com.

$ host 34.171.68.17
17.68.171.34.bc.googleusercontent.com.真蜘蛛反出来全是一个格式:baiduspider-数字.crawl.baidu.com。那台冒充的反出来是 googleusercontent.com——谷歌云的机房。百度不会借谷歌云来抓站,当场穿帮。
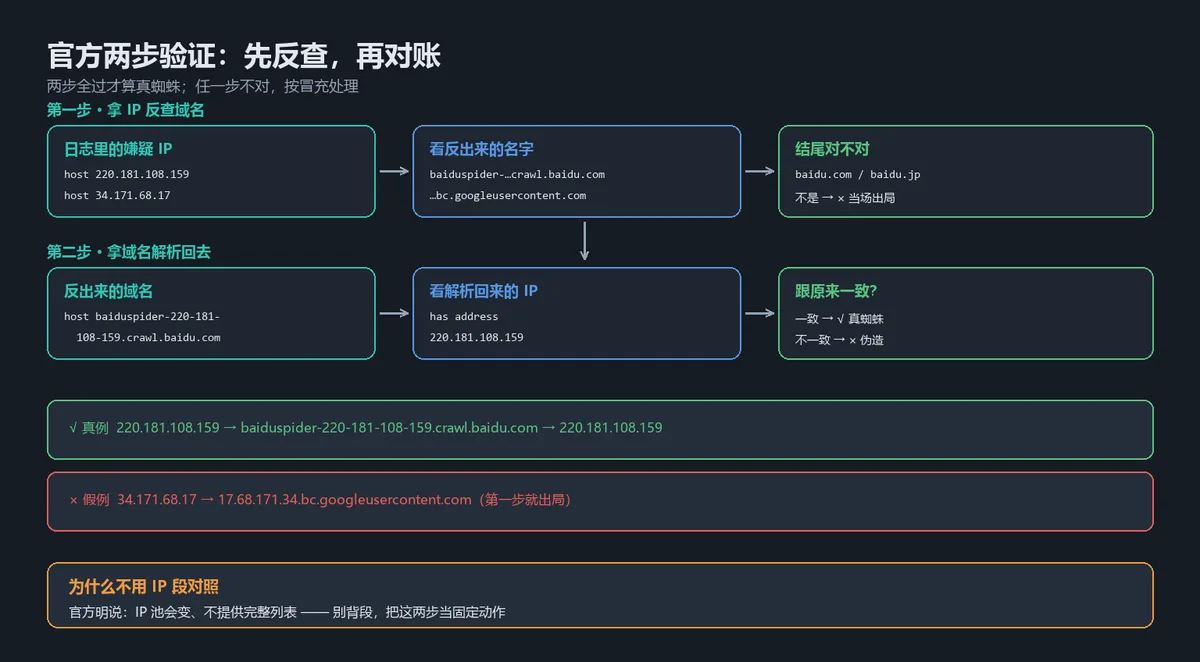
官方给的办法其实是两步。第一步反查,域名以 baidu.com 或 baidu.jp 结尾。第二步把反出来的域名再解析回去,看 IP 是不是原来那个。
$ host baiduspider-220-181-108-159.crawl.baidu.com
baiduspider-220-181-108-159.crawl.baidu.com has address 220.181.108.159
第二步我一开始没当回事,后来翻站长平台的说明才看到它的用处:两头都对上,才防得住有人伪造反向记录。多几秒钟,做全了踏实。
host 这个命令 Windows、Mac、Linux 都自带,不用装东西,本机就能查,不必登服务器。
为什么不直接记 IP 段
有人会想:把百度的 IP 段存成表,来一个对一个,不是更快?
官方明说了:IP 池会变,不提供完整列表。网上流传的那些段,今天对,过阵子未必。我这次抓取,19 条真蜘蛛就散在 18 个 IP 上——记表格不如记反查这个动作,一条命令的事。
(顺带一句:我以前也把"自称蜘蛛"直接当过真蜘蛛,61 次"抓取"全是我自己的出口 IP 干的,那篇里有完整过程。)
光看抓什么,也会看走眼
反查是硬判据,行为只能当旁证。正常蜘蛛的动线是先 robots.txt,再 sitemap,然后顺着链接抓页面。扫描器不管这些,上来就找 /.env、/api/config,404 也照扫。
但只看行为也会错怪。我之前对死链日志,发现提交过的死链还在被抓,差点写成"百度拿着我的清单逐条核对"——对完 IP 才发现是我自己的脚本在跑验证。连抓死链的都未必是百度,那篇有这段。
真蜘蛛来得多也不代表好事。它 9 天来了 6 次,5 次喂了 404 死链,一篇正文都没抓,账记在这。
所以现在我看日志的顺序固定了:UA 筛嫌疑人,IP 反查定案,行为只当旁证。下次日志里再冒出一条 Baiduspider,先别急着高兴——拿 IP 跑一遍这两步,再决定高不高兴。