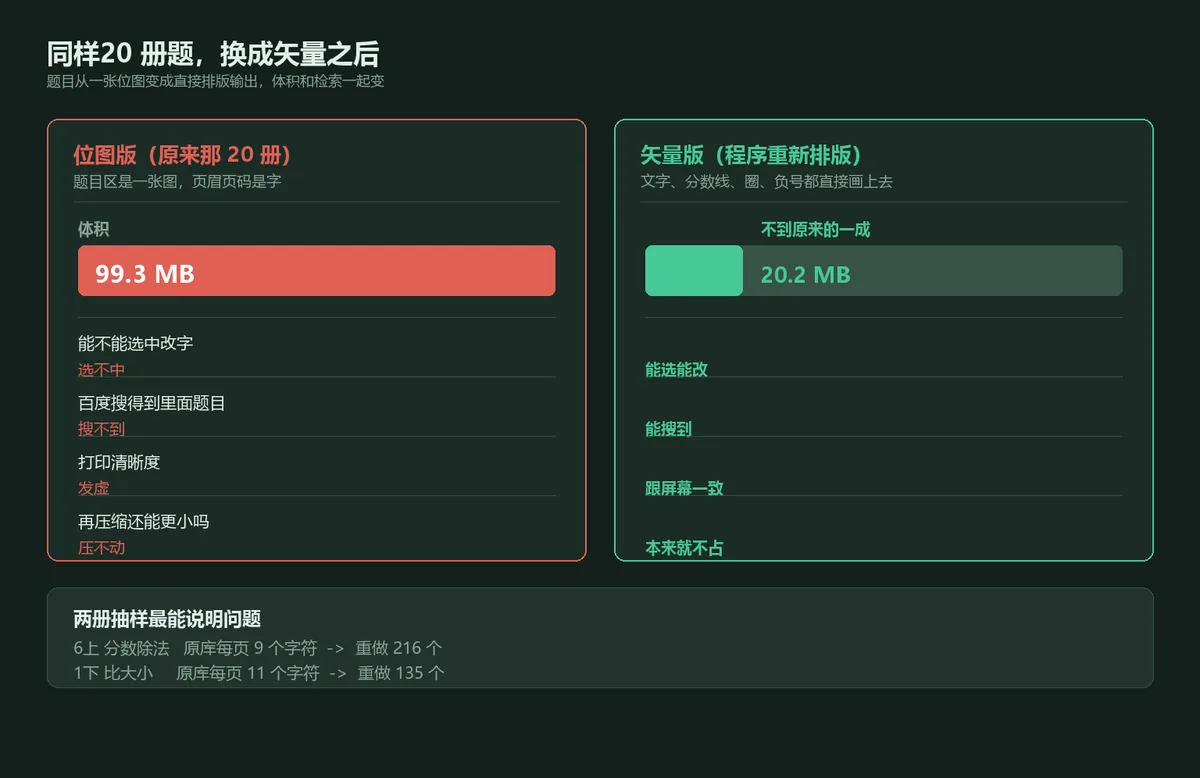
上周我在整理一批 PDF 口算题,准备打包上传。一整个文件夹 20 册,加起来 99.3 MB。
先说结论,省得你翻到最后:压不动就别压了。文件大的原因是里面的题目是位图,不是分辨率高。 同样这批内容,重新生成成矢量之后,体积从 99.3 MB 掉到 20.2 MB,题目还能直接选中改字。
压缩只能压掉 10%,而且越压越糊。这是两回事。
以为是分辨率太高
正常人的第一反应是开压缩软件降画质。第一册我确实这么干了,降完一对比,题目边缘的横线和分数线开始发毛。回头看体积,只从 4.8 MB 变成 4.3 MB。
省下的 0.5 MB,换来的是这册彻底不能用了。这一步白干。
问题不在压缩率上,在于我压的是一张本来就不该存在的图片。
怎么分清一个 PDF 到底是哪种
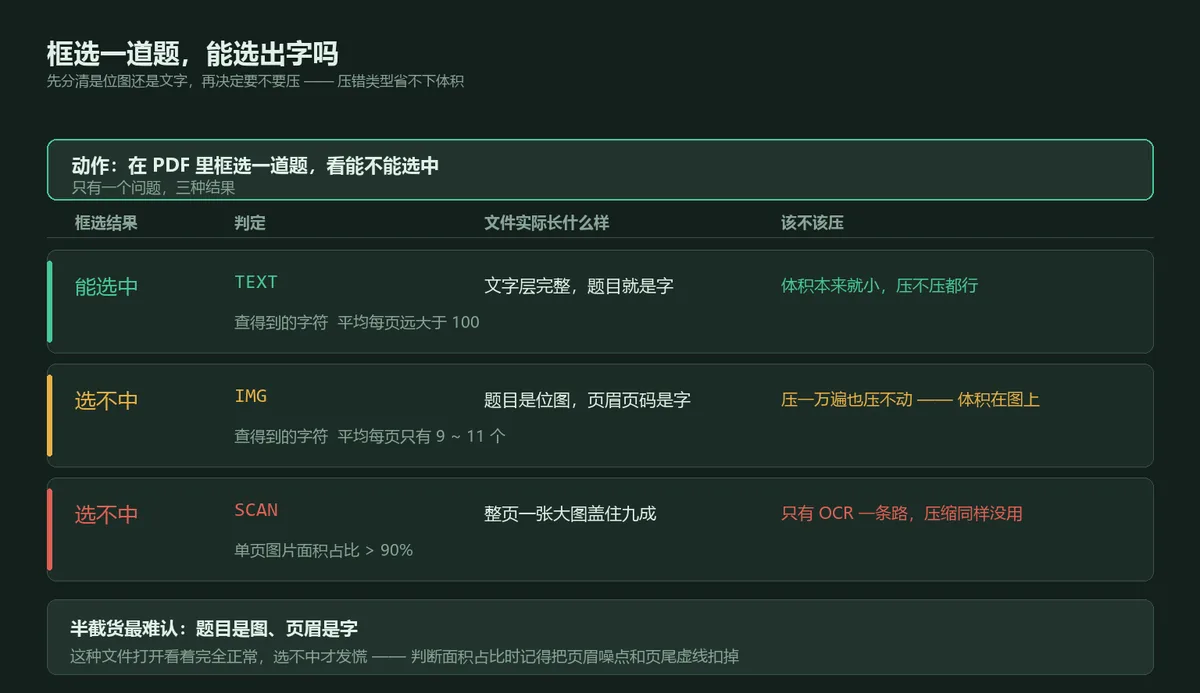
肉眼有个笨办法:打开文件,框选一段题目,看能不能选中字。能选中就是文字层,选不中就是一张图。
但这个办法有个坑:有的册子一半是图一半是字。页眉、页码是文字,能选中;题目区是位图,选不中。这么一看还以为它是正常文本文件,结果题目一个字都复制不出来。
我用脚本查了两轮。判断口径就两个数:每页抽出多少个文字字符,以及图片实际铺了页面多大面积。
# 页面上的图要扣掉装饰件,否则页眉噪点会把面积比例顶上去
DECOR = {(5114, 900), (4247, 12)}

chars = len(''.join(page.get_text('text').split()))   # 本页文字字符数
area  = 0.0
for im in page.get_images(full=True):
    if (im[2], im[3]) in DECOR:        # 噪点、页尾虚线,不算内容
        continue
    for r in page.get_image_rects(im[0]):
        area += r.get_area()
ratio = area / page.rect.get_area()
判定分三档:
| 类型 | 判据 | 实际长什么样 |
|---|---|---|
| SCAN | 单页一张大图盖住 90% 以上 | 扫描件,整页一张照片 |
| IMG | 图片面积占比超 15% | 题目是图,页眉页码是字 |
| TEXT | 图片只剩装饰 | 正常文本 PDF |
79 册跑完,出来的结果是 59 册 TEXT、20 册 IMG、SCAN 零册。
零册整页扫描。这个结果我事先没料到 —— 我一直觉得 20 册是「图片版 PDF」,以为就是拿手机一页页拍的。
每页 9 个字符的册子
数字比判断更有说服力。挑两册看每页平均文字量:
6上 分数除法      原库  每页  9 个字符  →  重新生成  216
1下 比大小        原库  每页 11 个字符  →  重新生成  135
9 个字符是什么概念。一页 36 道分数除法题,能抽出 9 个字,说明页面上除了页码和页眉那点东西,一个题目字都是图片。
那句「图片版的 PDF」,说到底就是题目区被做成了一张位图。这种文件体积大、搜不到题、复制不了、打印发虚,全是同一个原因。
让题目变回文字的做法
我没有去优化那张图,而是把它删了重画 —— 所有题目用程序直接排版输出,文字、分数线、圈、负号都是画上去的。这一步不是省体积,是换成品类型。
20 册全部换完,体积 99.3 MB → 20.2 MB,MD5 逐个跟生成件对上了 20/20。
不过重画这件事还有一层,我一开始漏了。
换之前我没有先核对页数,直接覆盖。干跑的时候被页数门槛拦下来了两册,理由是「页数跟预期对不上」:
- 一册文件夹标题写着「1000题」,实际 1100 题,33 页
- 一册写着「2000题」,实际 2100 题,63 页
不是我的脚本出错,是卖家放多了。 真按标题重建出来的版本是 30 页和 60 页。如果不拦这一道,客户数着页数对不上,还得多花一轮返工。
统计这一步我自己也数错过
上面那个「20 册 IMG」的数字,我一开始数出来是 16。
原因是我用了 grep -c 拿关键词匹配行数。那东西跨行也只算一行,而标记文件里有两行是一对的,一册被数成一、另一册漏掉。
改成逐行读、一册一册对,16 变19,再补上那一册半图半文的,正好 20。
统计类的结论必须逐条对,不要信 grep -c。 它给的数跟你脑子里想的那个数一模一样的时候,先怀疑它。
覆盖率这件事我也没深究明白:为什么这批册子只有题目区域是图,页眉页码还是文字。按理说生成工具是整页一起出的,不会只切题目。这块我没查下去。
我的判断标准
现在我拿到一个 PDF,只问一句:框选一道题,能选出字吗?
选得出,走正常流程,压不压都行。选不出,先看是不是「题目图、页眉字」这种半截货——那种文件压一万遍也压不动,因为体积在图上,而图不该存在。
这一步以前我是靠文件大小猜的。79 册里有 20 册异常,猜错了几次。
关于矢量重排怎么把中文塞进 PDF,我另写过一篇处理中文 PDF 时字体踩过的那些坑;整批文件的体积对比则用到了之前测的WebP 压缩参数那套口径 —— 位图那边压不动,矢量这边根本不压缩。