Excel 双击打开一个 CSV,第一列的中文全是「鍒ラ」这种看不懂的字符。文件是程序导出的,编码那一栏明明写着 UTF-8。
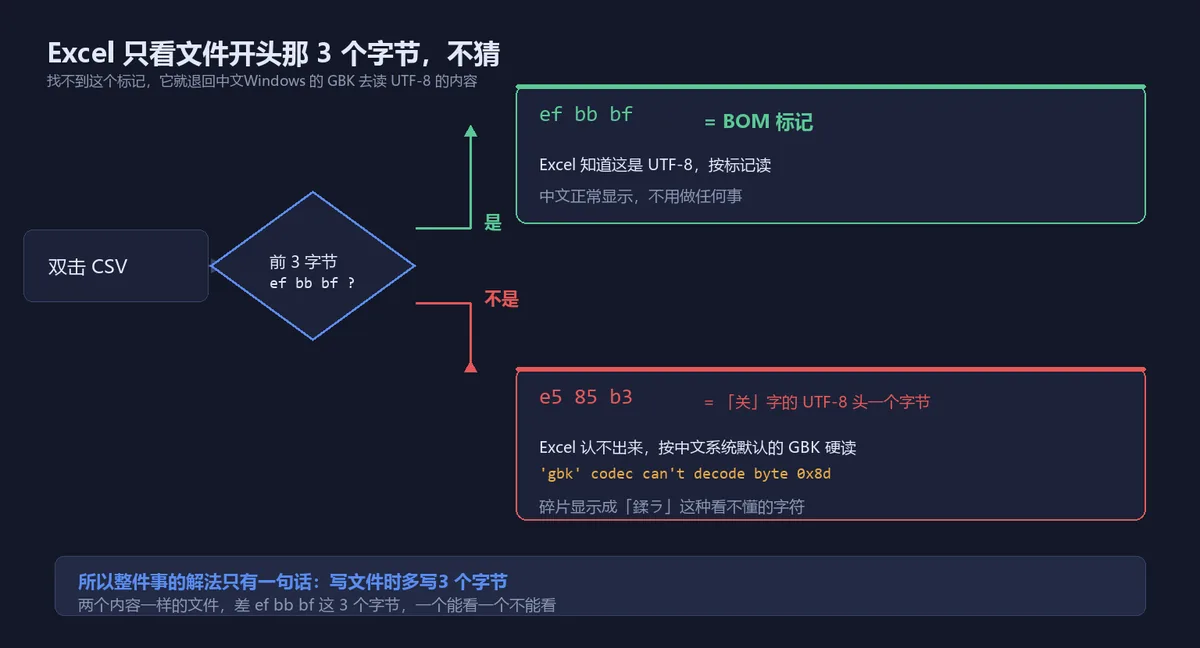
先说结论,省得你翻到最后:文件没坏,编码也没选错。缺的是文件开头那 3 个字节。
怀疑是文件坏了
我一开始也觉得这文件有问题。程序自己读回来是正常的中文,一行不少,字数对得上。同一份文件拖到记事本里打开,中文也正常。
那就不像传输过程中被截断了。
怀疑是编码选错了
Excel 双击打开 CSV 的时候根本不看扩展名,也不问编码,它按自己的规矩来:先找文件开头有没有一个特殊标记,找到了就照着那个标记指定的编码读;找不到,就退回系统默认的编码,也就是简体中文 Windows 上的 GBK。
那试试让它走 Excel 的导入向导,手动指定 UTF-8。没用,还是乱码。
再换 WPS 打开。同样乱码。换别的工具也没用。到这一步就该意识到:问题不在读文件的软件上,在文件自己身上。
怀疑是程序读文件的顺序错了
那就从程序这边查。我的脚本读 CSV 是按 utf-8-sig、utf-8、gbk、gb18030 这个顺序挨个试的,理论上不会读错。
我干脆把那个 CSV 用 gb18030 硬解一次,看看到底哪一步崩的:
'gb18030' codec can't decode byte 0x8d in position 8: illegal multibyte sequence崩了。gb18030 是 GBK 的超集,按理说能覆盖更多字节,连它都解不开,说明这个文件的字节根本不是中文双字节编码的产物。
那就只有一种可能:文件本身是 UTF-8,而 Excel 拿 GBK 去读它。
两套编码给同一个汉字排的字节不一样。读出来必然是这种半汉字半符号的碎片。
我造了两个内容一模一样、只有开头差 3 个字节的 CSV。对比了一下。
nobom.csv  size= 80  first6= e5 85 b3 e9 94 ae
bom.csv    size= 83  first6= ef bb bf e5 85 b3
nobom.csv  -> GBK 解码失败: 'gbk' codec can't decode byte 0x8d in position 8
bom.csv    -> Excel 看到 BOM, 按 utf-8 解码 -> OK
光看程序打印不够,我把这两个文件丢到命令行里,用最土的办法验一遍:
head -c 6 nobom.csv | xxd
head -c 6 bom.csv | xxd
grep -c $'\xef\xbb\xbf' nobom.csv bom.csv
00000000: e585 b3e9 94ae ......
00000000: efbb bfe5 85b3 ......
nobom.csv:0
bom.csv:1ef bb bf 只在第二个文件里。差的那 ef bb bf 就是那 3 个字节,术语叫 BOM(字节顺序标记)。它的作用只有一个:告诉读文件的程序「后面的字节请按 UTF-8 处理」。Excel 只认这个提示,不靠猜。
我一开始的方向整个反了。我一直在想「怎么让 Excel 猜对」,可 Excel 根本不猜,它只认标记。
那就把它写进去
写文件的时候把编码从 utf-8 换成 utf-8-sig,多出来的那三个字母就是干这个的:
# 之前:Excel 双击打开是乱码
with open("词库.csv", "w", encoding="utf-8", newline="") as f:
    f.write("关键词,日检索量\n角色档案卡,320\n")

# 之后:Excel 双击直接正常显示
with open("词库.csv", "w", encoding="utf-8-sig", newline="") as f:
    f.write("关键词,日检索量\n角色档案卡,320\n")
两行只差三个字符,文件从 80 字节变成 83 字节。多出来的 3 个字节不是内容,是给 Excel 看的说明牌。
已经发出去的 CSV 不用重新生成,让对方用 Excel 的「数据 → 从文本/CSV」导入,在编码那一栏手动选 UTF-8 也能看,只是多一步操作。
这件事我另外记一笔,跟它同源的一个坑当时也踩过:Python 处理中文 PDF 时字体踩过的那些坑 —— 字符这东西,存的时候和读的时候得用同一套规矩,不然全是乱码。
顺带一个反方向的坑
同一台机器上,.bat 文件的规矩是反的:必须存 GBK,存成 UTF-8 无 BOM 就会炸。
那天我写了个一键下载的 bat,双击之后 cmd 报 '1' 不是内部或命令,后面跟一行乱码。主程序的中文提示显示得好好的,只有 bat 自己那两行炸了。根因是 cmd 按系统默认的 GBK 去读这个 bat,UTF-8 的中文字节被切成了碎片,碎片拼出了一条不存在的命令。
那次我是这么修的:
# UTF-8 + LF 行尾 —— 复现出完全一样的报错
# GBK + CRLF 行尾 —— 输出正常,零报错
iconv -f UTF-8 -t GBK run.bat.tmp > run_gbk.bat
sed -i 's/$/\r/' run_gbk.bat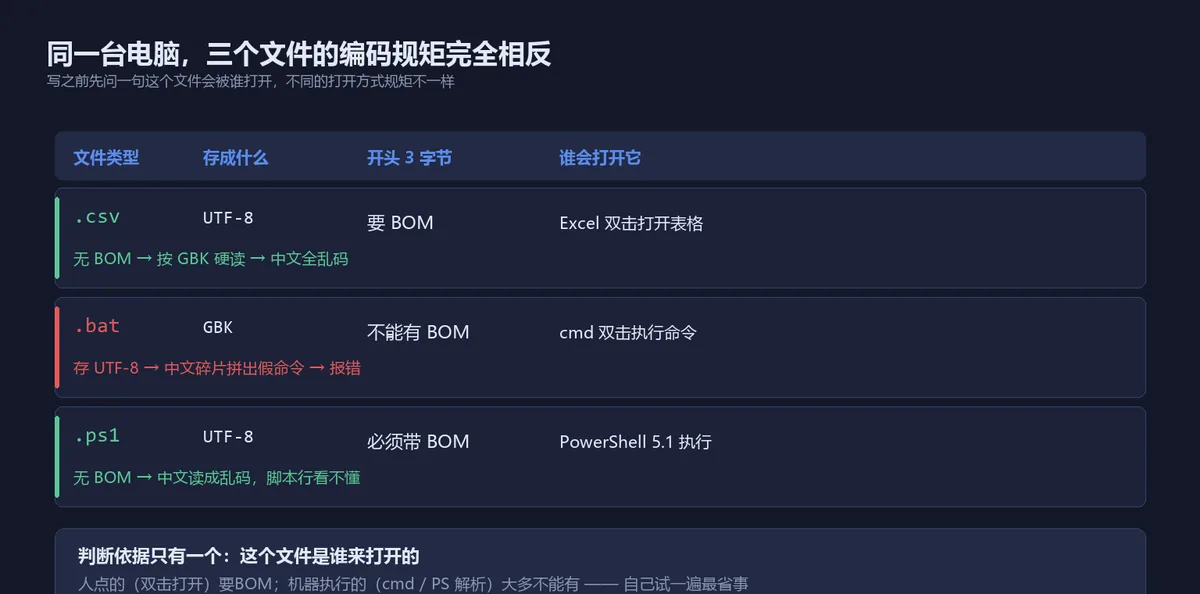
同一台电脑,同一批文件,规矩却不统一:CSV 要 UTF-8 带 BOM,bat 要 GBK 不带 BOM,ps1 又要 UTF-8 带 BOM。我没有把这套规矩背下来,每次都得现场试一遍 —— 这块我没深究出个所以然,只能记住每个文件类型的例外。
那份词库表最后是从词库报告里导出来的,五万多个词。导出脚本改了一行编码之后,对方打开就是正常中文,一个字都不用动。