先说结论:-1 不是工具坏了,是普通VIP 没有那个字段的权限。 判断一个词有没有搜索量,别在 5118 里找数字,去看百度下拉的联想词—— 只要下拉里出现「下载、网盘、模板、全套」这类词,就说明有人真在找东西付钱。
我 10 月 8 号花了一整天才搞清这件事。中间踩了个坑差点把结论写反。
我原来以为 5118 挖出 409 个词就能直接用
那天我想做百度贴吧 SEO,先去 5118 挖词。
用「小红书提示词」当种子词,点了挖掘,出来 409 条。我以为这批词是宝——409 个词,挨个去贴吧发帖,怎么都能捞到几个能排上去的。
结果点进数据字段,搜索量那一列全是 -1。
我第一反应是工具坏了。换了三个功能:长尾词挖掘、相关词、需求图谱——全是 -1。 又换了种子词「小红书文案」,这回数到 11 万多条,总不至于也坏了吧。点开,还是 -1。
折腾了一个多小时,我开始怀疑是不是姿势不对。
原来 -1 是权限墙,不是 bug
我去看了 5118 的官方权限表。两条写得明明白白:
关键词指数数据:不含
流量词挖掘导出:不可
-1 是它在导出文件里给没权限的字段留的占位符。文件是导出了,字段也在, 就是不给真值。
这跟百度收录查不到某些 site: 结果是一个性质——不是没数据,是没给你看数据的权限。
知道这个之后回过头看,那天收集到的所有 -1 都解释通了。 我居然花了一个小时去怀疑「姿势不对」,早该先去看权限表。
但下拉词这个接口是能用的
既然 5118 给不了搜索量,就换个数据源。百度自己的下拉接口不用登录:
import json, urllib.request, urllib.parse

UA = {"User-Agent": "Mozilla/5.0"}
url = "https://www.baidu.com/sugrec?prod=pc&wd=" + urllib.parse.quote("小红书文案")

with urllib.request.urlopen(
        urllib.request.Request(url, headers=UA), timeout=12) as r:
    d = json.loads(r.read().decode("utf-8", "ignore"))

words = [x["q"] for x in d.get("g", []) if x.get("q")]
print(len(words), words[:3])
这个能返回。40 个词里跑下来,有 10 个带下拉,其余 30 个直接空数组。
跑法就是这个循环:
# 拿一批词的下拉联想词,落成 CSV 方便事后拆后缀
for w in "小红书文案提示词" "简历模板下载" "直播话术"; do
  python check_baidu_sug.py "$w" >> 流量验证.csv
done
但「有返回」不等于「有流量」。 我第一次拿到这批结果的时候差点得出反向结论—— 因为判断标准用的是「有没有下拉」,而下拉只证明有人搜过这个词, 不证明搜的人多。
真正管用的判据是:下拉的联想词里,词本身后面跟的是什么后缀。
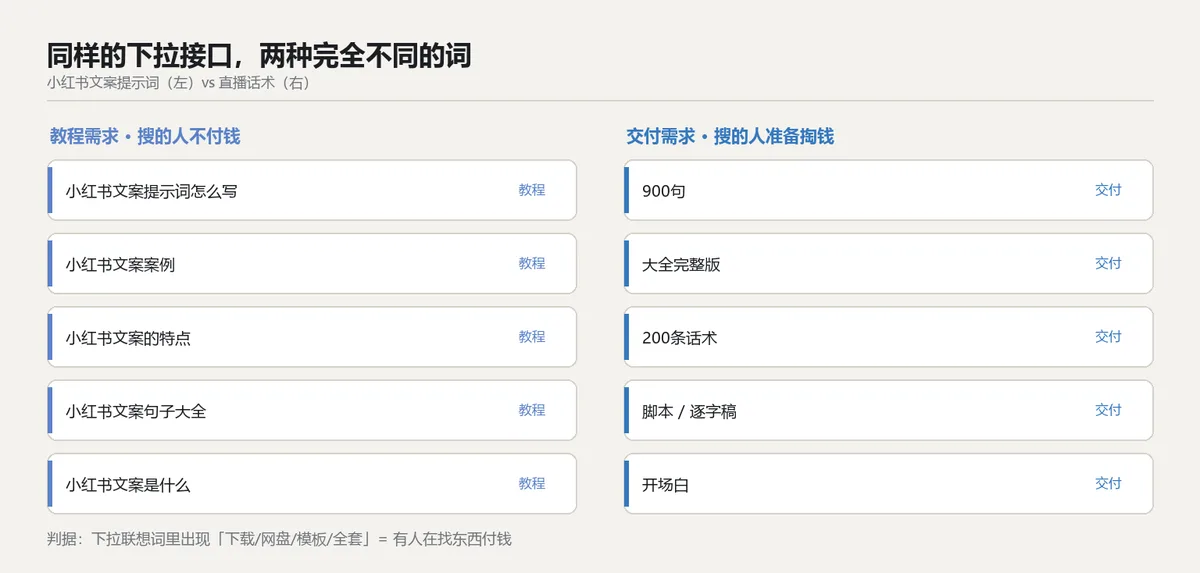
同一批词,下拉后缀分成两类
我把 40 个词的联想词按后缀拆开看,发现分得很干净:
怎么写 / 是什么 / 怎么弄        ← 教程需求,搜的人不付钱
下载 / 网盘 / 模板 / 全套/ 可编辑  ← 交付需求,搜的人准备掏钱
小红书这批词,几乎全是第一类。举几个原样:
小红书文案提示词怎么写
小红书文案案例
小红书文案的特点
小红书文案句子大全全是「怎么写」「案例」「是什么」。没有一个带「下载」或「网盘」。
这意味着:在百度搜「小红书文案提示词」的人,是想让别人教他怎么写,不是想花钱买一份。
产品方向从这一步就错了。
换个母词对一下,反差特别明显
我拿「直播话术」做同样的验证,下拉出来的联想词是这样的:
900句
大全完整版
200条话术
脚本
逐字稿
开场白
同样是跑下拉接口,一个全是「怎么写」,一个全是「句」「大全」「脚本」。 前者是来学的,后者是来拿东西的。
顺手还挖出一个细节:搜「憋单」有下拉,搜「逼单」没有。 用户搜的是他的行业黑话,不是我习惯说的那个词。
中间踩的第二个坑:我的脚本把限流当成了没数据
写脚本批量查首页域名的时候,我发现十条里九条返回空。
一开始我以为这批词首页真的没东西。往回翻代码才看明白:
def serp_domains(w):
    try:
        html = urllib.request.urlopen(...).read().decode("utf-8","ignore")
    except Exception:
        return []          # ← 异常和「真的没有」被混成同一个结果
    ...
我在 except 里直接 return [],然后 CSV 里那批数据全标成了 ⏳限流无数据。
实际上后来人工打开浏览器查,是能查到的。是我把网络异常和「这词没竞争」混成了一件事, 然后拿这个错数据去判断选品。
同一份 CSV 里,选品验证_候选产品.csv 的首页贴吧数一列都是 0, 而长尾细分那份却有 tieba.baidu.com——同一批数据,两个脚本,结果不一致, 这本身就说明有一个是错的。
漏掉的那次校验,让我在报告里写下了跟事实相反的结论。
手工查首页最省事的办法,是直接打开浏览器搜一遍,然后看贴吧帖的发帖时间:
# 人工核一条,看首页贴吧帖是新的还是 3 年前的
# 新的(近 1 年)= 还能排;全是老帖 = 换词
grep -n "tieba" 选品验证_长尾细分.csv | head -5
现在这套判据是这样的
把踩过的坑合起来,选词流程我改成这样:
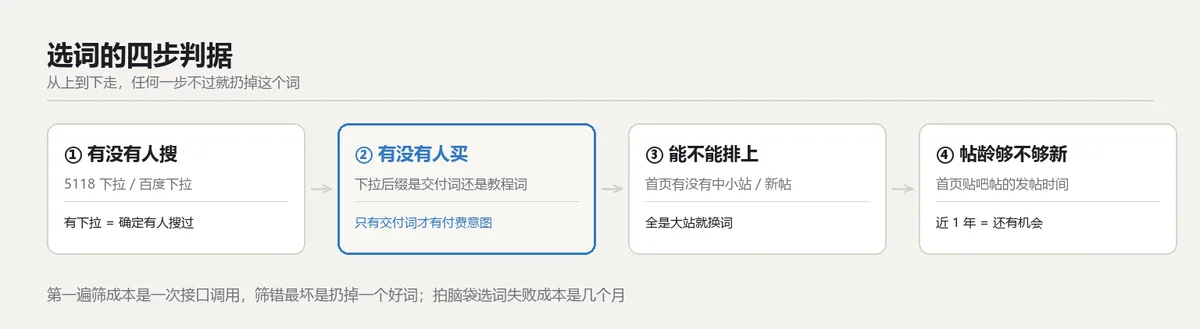
| 步骤 | 用什么判 | 为什么 |
|---|---|---|
| 有没有人搜 | 5118 下拉或百度下拉 | 有下拉 = 确定有人搜过 |
| 有没有人买 | 下拉后缀是交付词还是教程词 | 只有交付词才有付费意图 |
| 能不能排上 | 首页有没有中小站/新帖 | 全是大站就换词 |
| 帖龄够不够新 | 首页贴吧帖的发帖时间 | 近 1 年 = 还有机会 |
第一遍筛用下拉,成本是一次接口调用;筛错的最坏结果是扔掉一个好词。 对比拍脑袋选词,失败成本是几个月。
宁可漏,不可错。
我现在还在验证的
下拉接口只能证明「有人搜过」,证明不了「搜的人多」——免费数据拿不到精确搜索量, 这是物理上限,不是方法问题。
所以这套流程最终要不要成,还得看发帖之后的实际排名。这一步我暂时没有结论。