139。这是 Windows 上原生崩溃的退出码,Python 报错只到这一行,什么都不说。
我那会儿在改一个批量转文字的工具,扫描件 PDF 转纯文本。跑到几十页那会儿进程就没了,日志最后一行停在识别阶段,连异常都没抛出来。
段错误跟普通报错不一样。普通报错会甩你一句「文件不存在」或者「参数不对」,你能顺着改。段错误是程序自己把自己踩死了,连辩解都没有。
先说结论:这种崩溃大概率不是你的代码有毛病,是某个组件在你这台机器上根本不兼容,而且降版本不一定管用。
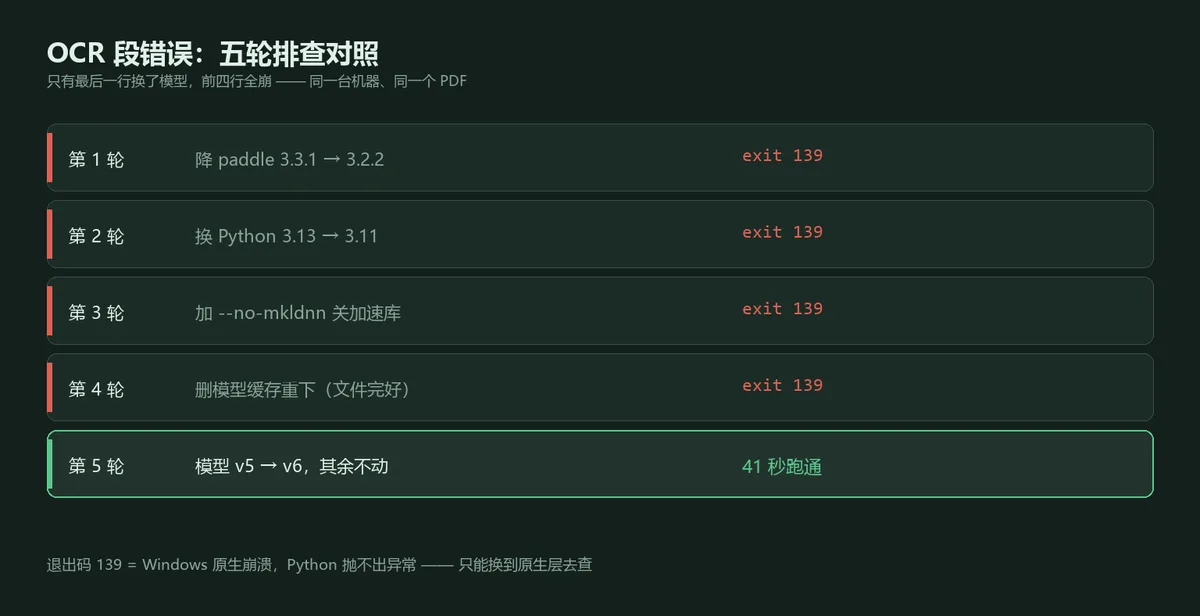
四轮排除,全崩
我当时的排查顺序是这样的。
第一轮,看是不是 paddle 版本不对。文档写着 3.2.x 是稳的,我装的 3.3.1。降到 3.2.2 再跑,还是 139。
第二轮,怀疑 Python。会不会 3.13 跟这个包不合?换 3.11。崩。
第三轮,怀疑 CPU 加速库。oneDNN 跟别的库有版本冲突的传闻挺多,加 --no-mkldnn 关掉。崩。
第四轮最阴——模型缓存下载坏了。翻缓存目录,JSON 在,权重参数文件也在,看着好好的。崩。
这四轮我是这么跑的,命令现在还留在测试脚本里:
python -m pdf2txt --ocr-version PP-OCRv5 --input-dir pdfs   # exit 139
python -m pdf2txt --ocr-version PP-OCRv5 --paddle 3.2.2     # exit 139
python -m pdf2txt --ocr-version PP-OCRv5 --python 3.11       # exit 139
python -m pdf2txt --ocr-version PP-OCRv5 --no-mkldnn         # exit 139
python -m pdf2txt --ocr-version PP-OCRv6 --input-dir pdfs   # 41s,出来了
最后一行只改了一个参数。
四轮下来我坐在那儿想:会不会是这台机器有毛病。
转折点,是交叉验证救的
第五步是顺手做的。我把已经下载好的上一代模型指过来,跑同一页。
过了。
同一个 paddle,同一个 Python,同一个 oneDNN,同一份缓存,一个都没动,只换了模型名。跑通了,41 秒一页。
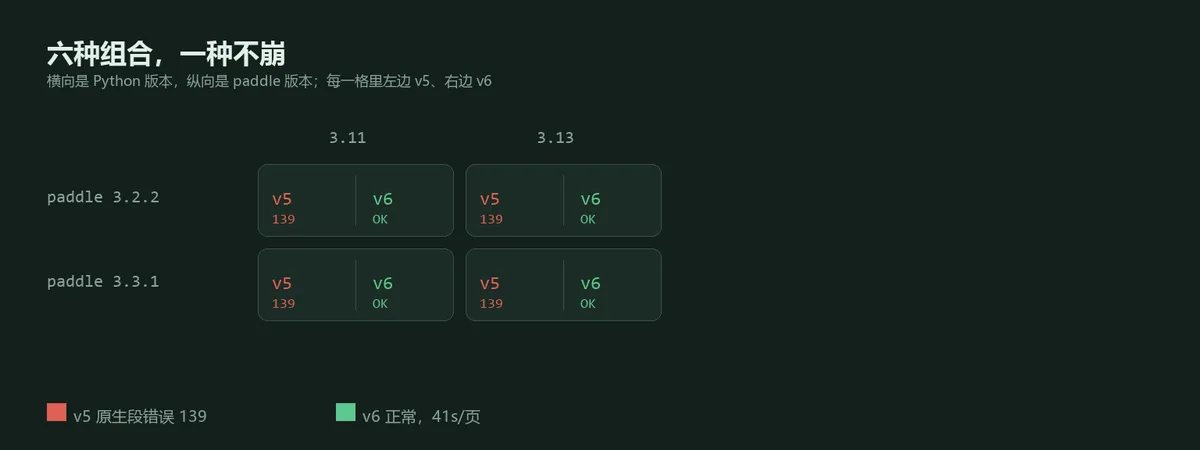
我一开始排的顺序就是错的。
模型是唯一一个我没怀疑的对象,因为它不报错、不警告,装的时候一切正常,第一次跑也正常——它是处理到某一页图像时才崩的。一个「装得好好的东西」,很难被列进嫌疑人名单。
两类崩溃根本不是一回事
顺手记一个区分点,这个我到现在还在用。
换 paddle 版本那会儿崩过一次,报的是 NotImplementedError。Python 层的异常,有 traceback,能看到哪个文件哪一行。
v5 那个模型崩的时候什么都没有,就是 139。原生层崩了,Python 压根不知道发生了什么。
没有 traceback 的崩溃,往底层想;有 traceback 的崩溃,先看代码。
我现在固定这么排:换模型版本 → 换 paddle 版本 → 换 Python 版本 → 查加速库 → 查缓存。模型排第一,理由就是上面那句——一个装得好好的东西最容易被漏掉。
同一件事还有另一面。之前用 5118 跑挖词报告,报告十项校验全绿、表格漂亮,数据从第一行起就是错的(那份报告出来我差点信了)。工具说「成功」和结果对,是两件事。这回也一样:程序跑到一半自己死了,只能说明它撞上了什么,撞的是什么,得另找证据。
现在怎么记
README 的 FAQ 里我写成三层排查,顺序还是模型版本打头:
# 一,换模型版本(默认就是 PP-OCRv6)
python -m pdf2txt --ocr-version PP-OCRv6 --input-dir pdfs

# 二,关掉 CPU 加速库,oneDNN 路径不兼容的机器用
python -m pdf2txt --no-mkldnn --input-dir pdfs

# 三,退回单进程,排除多进程抢资源
python -m pdf2txt --workers 1 --input-dir pdfs
第一条最管用,我实际就靠它解决的。后两条是给别的机器留的备用,那台机器到现在还没出现过。
还有一类坑是同一门手艺里的:不报错、只是画出来不对。我画文章配图时中文全变方块,也是同一种「看起来能跑」的蒙骗(Python 画中文图,我撞了三个字体坑)。这类问题的排查顺序也一样——先换最可疑的那个单一变量,别一上来就大改。
至于为什么偏偏是这个模型崩,我没深究。同一代的其他模型在别的机器上有没有事,我不知道。能确定的是我这台:GTX 1080,换完 CUDA 库重装了一次,同一页 20 秒降到 0.6 秒,识别结果一个字没变。慢是另一回事,崩是另一回事,两件事别混着调(那组参数我是一张张试出来的表)。
4 轮排除,1 个模型。41 秒一页,稳的。